
گوگل با عرضه دو مدل Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking، قابلیتهای صوتی بلادرنگ خود را برای ساخت تجربههای مکالمهای پیشرفتهتر توسعه داده است. این دو مدل تنها پنج روز پس از عرضه GPT-Live-1 توسط OpenAI معرفی شدند و نشان میدهند که مدلهای صوتی بلادرنگ به یکی از محورهای مهم توسعه هوش مصنوعی تبدیل شدهاند.
در این مقاله، مهمترین قابلیتها و مشخصات فنی جمنای لایو را بررسی میکنیم و عملکرد آن را در بخشهای مختلف با GPT-Live-1 مقایسه خواهیم کرد:
- معماری و عملکرد صوتی: بررسی قابلیت Speech-to-Speech و نحوه پردازش مکالمه صوتی بلادرنگ
- استدلال صوتی: بررسی نحوه مدیریت مکثها، پاسخگویی همزمان و ارائه روند استدلال در مکالمه
- بنچمارکها و نتایج رسمی: بررسی نتایج منتشر شده برای Gemini 3.8 Live در معیارهای مختلف ارزیابی صوتی
- مقایسه با GPT-Live-1: بررسی تفاوت دو مدل از نظر تأخیر، کیفیت مکالمه و اجرای وظایف عاملهای هوشمند
- قیمتگذاری و بهینهسازی API: بررسی تعرفهها، Context Caching و راهکارهای کاهش هزینه استفاده از API
- دسترسی به گفتوگوی صوتی Gemini: بررسی روش استفاده از قابلیت مکالمه صوتی جمنای
مدل صوتی جمنای ۳.۸ لایو (Gemini 3.8 Live) چیست؟

Gemini 3.8 Live جدیدترین مدل صوتی گوگل است که بر پایه معماری بومی چندوجهی (Native Multimodal) توسعه یافته و برای مکالمه بلادرنگ طراحی شده است. این مدل برخلاف سامانههای سنتی که گفتار را ابتدا به متن و سپس دوباره به صدا تبدیل میکنند، میتواند ورودی صوتی را بهصورت مستقیم پردازش کرده و پاسخهایی با لحن، مکث و الگوهای گفتاری طبیعی تولید کند.
گوگل همزمان با این مدل، نسخه Gemini 3.8 Live Extended Thinking را هم معرفی کرده است. این نسخه برای انجام وظایف پیچیدهتر مانند حل مسائل ریاضی، کدنویسی و تحلیل داده بهینه شده و در حین پردازش، بازخوردهای صوتی میانمرحلهای ارائه میدهد تا جریان مکالمه حفظ شود و کاربر در زمان انتظار با سکوت طولانی مواجه نشود.
پارامترهای فنی و ورودیهای API در Gemini 3.8 Live
طبق دادههای ثبتشده در منبع رسمی گوگل، مشخصات فنی این مدل به شرح زیر است:
| مشخصه | جزئیات فنی |
| شناسه مدل (Model Code) | gemini-3.8-live |
| فرمتهای ورودی (Inputs) | متن، تصویر، صدا، ویدیو (Text, Images, Audio, Video) |
| فرمتهای خروجی (Outputs) | متن و صدا (Text, Audio) |
| سقف توکن ورودی (Input Limit) | ۱۳۱٫۰۷۲ توکن |
| سقف توکن خروجی (Output Limit) | ۶۵٫۵۳۶ توکن |
| آخرین بهروزرسانی | سپتامبر ۲۰۲۶ (شهریور ۱۴۰۵) |
تفاوتهای کلیدی جمنای لایو 3.8 با نسخه Extended Thinking
طبق مستندات رسمی توسعهدهندگان گوگل که در ۱۵ سپتامبر ۲۰۲۶ (۲۴ شهریور ۱۴۰۵ ) بهروزرسانی شدهاند، Gemini 3.8 Live در دو نسخه ارائه شده است. نسخه اصلی برای مکالمه صوتی سریع و طبیعی طراحی شده و Gemini 3.8 Live Extended Thinking برای انجام وظایف پیچیدهتر و نیازمند استدلال مناسب است. تفاوتهای اصلی این دو مدل را میتوانید در جدول زیر ببینید:
| ویژگی | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
| هدف اصلی | مکالمات روزمره، سریع، طبیعی و مقرونبهصرفه | حل مسائل پیچیده، استدلال چندمرحلهای و پردازش سنگین |
| قابلیت ویژه | درک سریع ورودیهای تصویری و تعویض خودکار زبان | استدلال صوتی (Vocalized Reasoning) و گزارش مرحلهبهمرحلۀ فکر کردن |
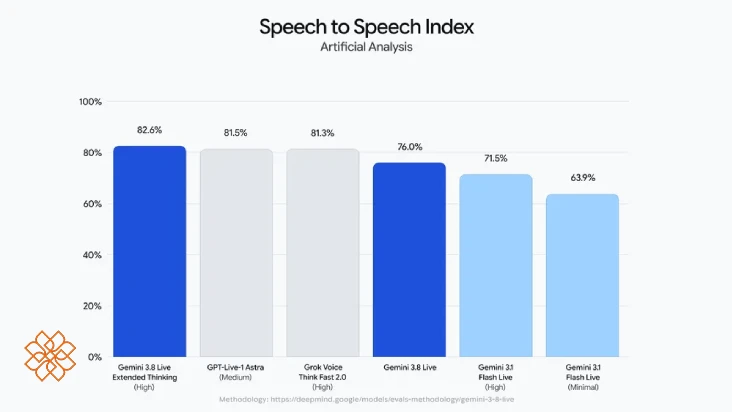
| امتیاز Artificial Analysis | حضور در رتبههای بالای ارزیابی کیفیت گفتار | امتیاز ۸۲٫۶ (رتبه اول شاخص گفتار به گفتار) |
| پشتیبانی زبانی | ۹۷ زبان (با تشخیص خودکار) | ۹۷ زبان (با قابلیت استدلال همزمان) |
قابلیتهای کلیدی؛ چرا Gemini 3.8 Live تجربه مکالمه صوتی را متحول میکند؟
تا پیش از این، مکالمه صوتی با جمنای یا سایر مدلهای صوتی چالش بزرگ قطعی کلام داشت؛ یعنی به محض اینکه مدل میخواست ابزاری را فراخوانی کند یا کدی اجرا کند، ارتباط صوتی قطع یا دچار مکثهای طولانی میشد. گوگل در سری ۳.۸ این مشکل را بهطور کامل برطرف کرده است.
اصلیترین قابلیتهای تکنولوژی جدید جمنای لایو عبارتند از:
- اجرای ابزارها بدون وقفه در صحبت: مدلها میتوانند هنگام صحبت با کاربر، در پسزمینه کدهای API را اجرا کنند یا به ابزارهای جانبی متصل شوند، بدون آنکه رشته کلام یا جریان تعامل قطع شود.
- درک بصری همزمان (Visual Grounding): در جریان گفتوگوی صوتی با جمنای، مدل میتواند ورودی دوربین یا تصویر را تقریباً بهصورت بلادرنگ ببیند و درباره آن صحبت کند (مثلاً تحلیل طرح روی تختهسیاه و کدنویسی همزمان بر اساس آن).
- پشتیبانی هوشمند از ۹۷ زبان: سیستم جدید تعویض خودکار زبان در میانهی مکالمه، نیاز به تغییر تنظیمات دستی را کاملاً از بین برده است.
همچنین در نسخه Extended Thinking، فرایند «فکر کردن» با جملات طبیعی و لحنی انسانی به کاربر گزارش داده میشود تا حس معطلی یا تاخیر در مکالمه ایجاد نشود.
بررسی عملکرد و بنچمارکها؛ Gemini 3.8 در برابر GPT-Live-1
Gemini 3.8 Live و GPT-Live-1 هر دو برای مکالمه صوتی بلادرنگ توسعه یافتهاند، اما در معماری و قابلیتهای خود تفاوتهایی دارند. طبق دادههای ثبتشده در گزارش کیفیت گفتار موسسه Artificial Analysis, عملکرد این مدلها بر اساس شاخصهای تاخیر (Latency) و طبیعی بودن صدا ارزیابی میشود.
در کنار این زیرساختها، چت جی پی تی فارسی هم یکی از گزینههای در دسترس برای کاربران است تا بتوانند مدلهای هوش مصنوعی متنی و تحلیلی را در یک محیط فارسیسازی شده تجربه کنند.
مقایسه جامع فنی مدل های صوتی Gemini 3.8 Live و GPT-Live-1
جدول زیر جزییات عملکردی و فنی این مدلها را در کنار یکدیگر مقایسه میکند:
| شاخص / ویژگی | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking | OpenAI GPT-Live-1 |
| توسعهدهنده | OpenAI | ||
| تاریخ عرضه | ۱۵ سپتامبر ۲۰۲۶ | ۱۵ سپتامبر ۲۰۲۶ | ۱۰ سپتامبر ۲۰۲۶ |
| معماری اصلی | Multimodal Audio Native | Multimodal Audio Native + Vocalized Reasoning | Advanced Voice Mode Generation |
| کیفیت گفتار (Artificial Analysis) | ۷۹٫۲ | ۸۲٫۶ (رتبه یک جهان) | ۸۰٫۴ (رتبه ۲) |
| میانگین تاخیر (Latency) | حدود ۲۴۰ میلیثانیه | حدود ۳۸۰ میلیثانیه (شامل زمان استدلال) | حدود ۲۸۰ میلیثانیه |
| استدلال صوتی (Vocalized Reasoning) | ❌ | ✅ (گزارش مرحلهبهمرحله فکر) | ❌ (توقف در استدلال سنگین) |
| پشتیبانی زبانی | ۹۷ زبان (سوئیچ خودکار) | ۹۷ زبان (سوئیچ خودکار) | ۵۰ زبان |
| قیمت ورودی صوتی (۱M توکن) | ۳ دلار | ۶ تا ۱۰ دلار | ۱۰ دلار |
| قیمت خروجی صوتی (۱M توکن) | ۱۲ دلار | ۲۴ تا ۳۰ دلار | ۳۰ دلار |
| قابلیت Tool Calling بدون قطعی | ✅ پشتیبانی کامل | ✅ پشتیبانی کامل | ❌ نیاز به مکث کوتاه در اجرا |
برای آشنایی کامل با زیرساخت، نحوه عملکرد و بنچمارکهای مدل صوتی اوپنایآی GPT-Live-1، راهنمای جامع زیر را مطالعه کنید.
جی پی تی لایو GPT-Live-1 مدل صوتی جدید OpenAI
تحلیل شاخصهای عملکرد گفت و گوی صوتی با جمنای ۳.۸ لایو
دادههای منتشرشده در مستندات و منابع رسمی توسعهدهندگان گوگل، عملکرد Gemini 3.8 Live Extended Thinking را در چند معیار مختلف نشان میدهد. این ارزیابیها، کیفیت گفتار، درک صوتی و توانایی مدل در اجرای وظایف پیچیده را بررسی میکنند:
- کیفیت گفتار (Artificial Analysis): بر اساس گزارش Artificial Analysis، این مدل امتیاز ۸۲٫۶ را در شاخص Speech-to-Speech به دست آورده است.
- اجرای وظایف عاملمحور (τ-Voice): مدل در ارزیابی τ-Voice امتیاز ۶۸٫۶٪ و در τ-Voice-banking امتیاز ۳۵٫۱٪ کسب کرده است. این معیارها عملکرد مدل را در اجرای وظایف چندمرحلهای و تعامل با ابزارها و APIها ارزیابی میکنند.
- درک صوتی Big Bench Audio : Gemini 3.8 Live Extended Thinking در این بنچمارک امتیاز ۹۷٫۷٪ را ثبت کرده است که عملکرد آن را در درک و استدلال روی ورودیهای صوتی نشان میدهد.
حل چالش تاخیر با گزارش صوتی استدلال (Vocalized Reasoning)
مدلهای هوش مصنوعی برای انجام استدلال چندمرحلهای و پردازشهای سنگین ممکن است به زمان بیشتری نیاز داشته باشند؛ مسئلهای که در مکالمه صوتی بلادرنگ میتواند به ایجاد سکوتهای طولانی منجر شود.
گوگل برای مدیریت این وقفه از مکانیزم Live Progress Narration استفاده کرده است.
در این روش، هنگام پردازش یک درخواست پیچیده، مدل با جملات کوتاه و طبیعی مانند «اجازه بده این موضوع را بررسی کنم…» به کاربر بازخورد صوتی میدهد.
به این ترتیب، مکالمه در زمان پردازش ادامه پیدا میکند و کاربر از وضعیت پاسخگویی مدل مطلع میماند.
کاربردهای مکالمه صوتی با جمنای در دنیای واقعی
پیادهسازی قابلیتهای مدلهای صوتی جدید گوگل، امکان ساخت محصولات هوشمندتری را فراهم کرده است. مهمترین سناریوهای کاربری این فناوری عبارتند از:
۱. دستیاری و اشکالزدایی صوتی کدنویسی
توسعهدهندگان میتوانند بدون دست زدن به کیبورد، منطق برنامهنویسی را زنده تشریح کنند تا مدل با استدلال همزمان، خطاهای کد را بهصورت صوتی گوشزد کند.
۲. مراکز تماس و پشتیبانی پیشرفته تلفنی
به لطف تاخیر زیر نیم ثانیه و پشتیبانی از ۹۷ زبان، سامانههای IVR میتوانند مکالمات پیچیده مشتریان را با لحنی کاملاً طبیعی و بدون قطع ارتباط مدیریت کنند.
۳. آموزش تعاملی و حل گامبهگام مسائل
در برنامههای آموزشی، مدل با بازگو کردن مراحل تفکر (Vocalized Reasoning)، دانشآموز را مرحلهبهمرحله در حل مسائل ریاضی و تحلیل داده راهنمایی میکند.
۴. دستیارهای همراه هوشمند با درک بصری
ترکیب جریان صوتی با ورودی دوربین (Visual Grounding) به کاربران اجازه میدهد در لحظه درباره آنچه میبینند (مانند سند اداری یا قطعه صنعتی) مشورت صوتی دریافت کنند.
بررسی سناریوهای عملیاتی نشان میدهد که رقابت در عرصه سیستمهای صوتی بلادرنگ وارد مرحله تازهای شده است؛ برتری در این میدان بیش از هر چیز به پایداری ارتباط، مدیریت تاخیر و حفظ جریان طبیعی گفتار بستگی دارد. کاربران و کسبوکارهایی که قصد بهرهگیری از این امکانات پردازشی را دارند، میتوانند از طریق سرویسهای هوش مصنوعی آنلاین به فناوریهای صوتی و متنی دسترسی داشته باشند.
راهکارهای بهینهسازی و کاهش هزینه API در جمنای لایو
استفاده از مدلهای گفتار به گفتار (S2S) به دلیل حجم بالای دادههای صوتی میتواند هزینههای زیرساختی را افزایش دهد. برای بهرهبرداری حداکثری از توان پردازشی Gemini 3.8 Series و مدیریت بهینه منابع، رعایت چند نکته فنی الزامی است:
مدیریت هوشمند سکوت با VAD (Voice Activity Detection):
ارسال پیوسته جریان صوتی (Stream) به API، حتی زمانی که کاربر سکوت کرده، مصرف توکن را به شدت بالا میبرد. با پیادهسازی سیستمهای لایه کلاینت برای تشخیص فعالیت صوتی (VAD)، تنها زمانی دادهها را به Gemini API بفرستید که صوت کاربر فعال است.
استفاده از سیستم Context Caching
اگر در برنامه کاربردی خود از پرامپتهای سیستمی طولانی، دادههای زمینه (Context) یا فایلهای راهنمای صوتی مشترک استفاده میکنید، با قابلیت کش کردن زمینه (Context Caching)، توکنهای تکراری را ذخیره کنید تا هزینه ورودی تا بیش از ۵۰٪ کاهش یابد.
انتخاب هوشمندانه بین دو مدل پایه و استدلالی
تمامی بخشهای اپلیکیشن شما نیازی به استدلال سنگین ندارند. برای سناریوهای ساده (مثل دریافت دستورات صوتی کوتاه یا پاسخهای احوالپرسی) از مدل Gemini 3.8 Live استفاده کنید و فراخوانهای پیچیده (مانند تحلیل محاسباتی یا استخراج داده از چند منبع) را به Gemini 3.8 Live Extended Thinking هدایت کنید.
دسترسی به Gemini 3.8 Live؛ راهنمای توسعهدهندگان و کاربران
دسترسی به امکانات صوتی بلادرنگ سری جدید Gemini 3.8 به دو روش مستقیم و واسط امکانپذیر است:
توسعهدهندگان و کسبوکارها (API مستقیم)
توسعهدهندگان میتوانند از طریق Google AI Studio و Vertex AI کلیدهای API را دریافت کنند. این مدلها ذیل پروتکل WebSocket و معماری Gemini Multimodal Live API ارائه شدهاند تا جریان صوتی (Audio Streaming) را با کمترین تاخیر ممکن منتقل کنند. همچنین فریمورکهای LiveKit، LangChain و Pipecat کتابخانههای یکپارچهسازی اختصاصی این مدل را عرضه کردهاند.
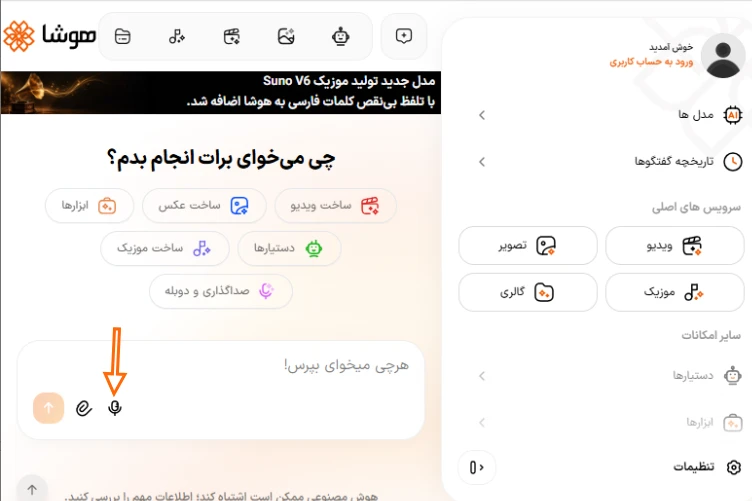
ارسال پیام صوتی و دسترسی کاربران ایرانی در هوشا
از آنجا که دسترسی مستقیم به APIهای گوگل برای کاربران داخل ایران به دلیل تحریمها و چالشهای پرداخت ارزی پیچیده است، استفاده از یک هوش مصنوعی همه کاره راهحلی پایدار محسوب میشود. از این طریق کاربران میتوانند بدون نیاز به تایپ دستی، درخواستهای اداری، ترجمه و برنامهنویسی خود را بهصورت صوتی ارسال کنند.
نکته فنی: امکان تعاملی ارسال پیام صوتی در هوشا یک رابط کاربری تسهیلشده برای پرسشوپاسخ روزمره است و نباید آن را با جریان ارتباطی تمامدوطرفه، بلادرنگ و بدون تاخیر APIهای سری Gemini 3.8 Live اشتباه گرفت.
جمعبندی؛ Gemini 3.8 Live چه تغییری در مکالمات صوتی ایجاد میکند؟
عرضه Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking، قابلیتهای مکالمه صوتی بلادرنگ گوگل را وارد مرحله تازهای کرده است. این مدلها با تمرکز بر پردازش صوتی بلادرنگ، استدلال و اجرای وظایف چندمرحلهای، گزینههای متفاوتی را برای توسعه تجربههای صوتی مبتنی بر هوش مصنوعی در اختیار توسعهدهندگان قرار میدهند.
انتخاب میان دو نسخه به نیاز پروژه بستگی دارد:
- سرعت و هزینه: Gemini 3.8 Live برای کاربردهایی که پاسخ سریع و تعامل صوتی روان اهمیت دارد، گزینه مناسبتری است.
- وظایف پیچیده و نیازمند استدلال: Gemini 3.8 Live Extended Thinking برای سناریوهایی طراحی شده است که به پردازش و استدلال بیشتر نیاز دارند و میتواند بازخورد صوتی میانمرحلهای ارائه دهد.
در نهایت، انتخاب مدل باید بر اساس عواملی مانند نوع کاربرد، میزان پیچیدگی وظایف، تأخیر قابلقبول، هزینه API و نیاز به ابزارهایی مانند Function Calling انجام شود. مقایسه این معیارها با نیازهای واقعی پروژه، تصویر دقیقتری از مدل مناسب برای هر کاربرد ارائه میدهد.
نویسنده: حمیده نیکویان
 ترمیم عکس با هوش مصنوعی؛ بهترین ابزارها + آموزش بازسازی عکس قدیمی
 Gemini 3.8 Live چیست؟ معرفی کامل کاربردها + بنچمارکهای مدل صوتی گوگل
 ساخت پست اینستاگرام با هوش مصنوعی؛ معرفی ۵ ابزار + آموزش طراحی
 ۳۲ پرامپت عکس پروفایل تست شده و متنوع (خانم و آقا)
 میوس Muse چیست؟ معرفی کامل ایجنت شخصی شرکت متا Meta
