
مدل Muse Wonder و مدل Muse Wonder Full در ۱۲ اکتبر ۲۰۲۶، برابر با ۲۰ مهر ۱۴۰۵، معرفی شدند؛ دو مدل جدید متا که برای پیگیری کارهای طولانی و چندمرحلهای طراحی شدهاند. محور این خانواده، حفظ اطلاعات مرتبط با کاربر و ادامهدادن کار هنگام بروز مشکل است. متا آنها را توانمندترین مدلهای خود معرفی میکند، اما برای قضاوت درباره رقابت با کلود و جیپیتی باید نوع آزمون و شرایط اجرای آن را هم دید.
ویدیوی رسمی معرفی مدل Muse Wonder و مدل Muse Wonder Full را مشاهده کنید:
- نسخه معمولی از روز رونمایی در رابط برنامهنویسی متا و ابزار Muse Code عرضه شده است.
- نسخه فول فقط در اشتراکهای مشخص Muse Code ارائه میشود؛ انتخاب حداکثر استدلال، مدل معمولی را به فول تبدیل نمیکند.
- هر دو مدل ورودی چندرسانهای و خروجی متنی دارند و پنجره زمینه آنها حدود یک میلیون توکن است.
- ارزیابی مستقل، پیشرفت نسبت به Muse Spark 1.3 را نشان میدهد؛ همزمان ضعفهایی در دانش و هزینه هر وظیفه دیده میشود.
معرفی مدل میوز واندر Muse Wonder و میوز واندر فول Muse Wonder Full

میوز واندر (Muse Wonder) و میوز واندر فول (Muse Wonder Full) مدلهایی برای عاملهای هوش مصنوعی یا ایجنتها (AI Agents) هستند؛ سیستمهایی که با استفاده از ابزارها، مراحل یک کار را اجرا میکنند. متا در اعلام رسمی ۱۲ اکتبر ۲۰۲۶، برابر با ۲۰ مهر ۱۴۰۵، نمونههایی مانند پیگیری درخواست بیمه، بررسی اجارهنامه و ساخت برنامه را مطرح کرده است. معرفی مدل و شروع دسترسی توسعهدهندگان همزمان بوده، ولی عرضه در تجربه کاربری Muse برنامهای جداگانه دارد.
این خانواده بر پایه مسیر توسعه Muse Spark ساخته شده و در مرکز داده پرومتئوس (Prometheus) متا آموزش دیده است. شرکت از مدلهای پایه بزرگتر و قویتر سخن میگوید؛ منابع بررسیشده تعداد پارامترها را مشخص نمیکنند. بنابراین «فول» را نباید صرفاً نام دیگری برای تنظیمات استدلال نسخه معمولی دانست.
قابلیتهای میوز واندر از دانش تخصصی تا کارهای طولانی
۱. دانش تخصصی برای کارهای روزمره و حرفهای
متا کاربردهای این مدلها را در حقوق، امور مالی، سلامت و برنامهنویسی برجسته میکند. در این کاربردها، مدل باید اطلاعات اسناد را بفهمد و خروجی قابل بررسی بسازد. برای آشنایی با تفاوت پاسخگویی ساده و اجرای یک فرایند، مفهوم هوش مصنوعی عاملمحور زمینه مناسبی است. کمک به فهم یک سند تخصصی نیز به معنی تأیید صحت همه پیشنهادهای مدل نیست.
۲. حافظه فعال برای بازیابی اطلاعات مرتبط
حافظه فعال (Active Memory) به حفظ اطلاعات مهم میان گفتوگوها و بازیابی آنها هنگام نیاز اشاره دارد. مثلاً در یک پروژه، ترجیحات و محدودیتهای قبلی باید در تصمیم بعدی لحاظ شوند. توضیح پژوهشی متا این ویژگی را برای تداوم کار ایجنتها مهم میداند؛ وجود حافظه بهتنهایی تضمین نمیکند هر جزئیات همیشه درست بازیابی شود.
هوش مصنوعی میوز Muse چیست؟ معرفی ایجنت شخصی شرکت متا Meta
۳. تمرکز فعال برای عبور از موانع
تمرکز فعال (Active Focus) یعنی عامل هنگام دشوارشدن کار، مسیر دیگری امتحان کند، خطا را جبران کند و هدف را پی بگیرد. در توضیح متا، مدل هنگام ابهام سؤال میپرسد و پیش از اقدام مهم با کاربر هماهنگ میشود. آزمون داخلی FocusBench برای سنجش پیگیری کار و SWE-Marathon برای پروژههای نرمافزاری طولانی استفاده شدهاند.
۴. برنامهنویسی و استفاده از رایانه
میوز واندر برای تغییر چند فایل، بررسی نتیجه و تکرار چرخه اصلاح کد طراحی شده است. مستندات متا همچنین فراخوانی ابزار (Tool Calling)، خروجی ساختاریافته (Structured Output) و کار با رایانه (Computer Use) را پوشش میدهند. ورودی شامل متن، تصویر، ویدیو، صدا و PDF است؛ خروجی خود مدل متن است. ابزارها میتوانند در اجرای کار نقش داشته باشند، اما این ویژگی را نباید با تولید مستقیم تصویر یا ویدیو توسط مدل یکی دانست.
نمایشهای پژوهشی متا شامل ساخت بازی آشپزخانه سهبعدی از تصویر، برنامهریزی دویدن با توجه به ترجیحات شخصی، طراحی هدیه سفارشی و چیدمان مهمانان عروسی است. اینها نمونههای منتخب شرکتاند و نتیجه آزمایش مستقل ما محسوب نمیشوند.
تفاوت مدل Muse Wonder با Muse Spark 1.3
تفاوت اصلی خانواده جدید با میوز اسپارک ۱٫۳، تمرکز بر کارهای پیچیدهتر و طولانیتر است. راهنمای انتخاب مدل متا واندر را برای تغییرات چندفایلی و هماهنگی زیرعاملها (Sub-agents) پیشنهاد میکند؛ اسپارک برای حجم بالای درخواستها و کارهای حساس به هزینه یا تأخیر مناسبتر معرفی شده است. دو خانواده درخواستهای سازگار دارند و جابهجایی بین آنها در رابط برنامهنویسی با تغییر شناسه مدل انجام میشود.
متا در مقایسه پژوهشی خود میگوید واندر فول روی وظایف ناآشنا، بهتر از روند مورد انتظار اسپارک ۱٫۳ عمل میکند. این ادعا درباره تعمیمپذیری (Generalization)، یعنی کاربرد تواناییها در کارهایی است که مشخصاً هدف آموزش تکمیلی نبودهاند. با این حال، اندازه پنجره زمینه افزایش پیدا نکرده و همچنان حدود یک میلیون توکن است؛ پیشرفت را نباید صرفاً به طول ورودی نسبت داد.
بنچمارکهای میوز واندر و مقایسه با رقبا
بنچمارک (Benchmark) مجموعهای از وظایف مشخص برای سنجش عملکرد است. جدول زیر تبدیل متنی جدول منتشرشده در صفحه رسمی مدل است؛ اعداد از منابع مختلف ترکیب نشدهاند. نتایج با حالت حداکثر استدلال (Max) ارائه شدهاند، بهجز استثنای مشخصشده برای فول در SWE-Marathon.
| آزمون | Muse Wonder Full (max) | Muse Wonder (max) | Claude Fable 5.1 (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max) |
| Personal Superintelligence Index | ۵۹٫۱ | ۵۴٫۳ | ۴۹٫۹ | ۵۴٫۵ | ۵۵٫۲ |
| Harvey LAB-AA | ۱۳٫۱ | ۱۰٫۰ | ۶٫۴ | ۸٫۶ | ۴٫۲ |
| Vals Finance Agent V2 | ۵۹٫۱ | ۵۶٫۶ | ۵۸٫۹ | ۵۳٫۵ | ۵۸٫۶ |
| HealthBench Pro | ۶۲٫۳ | ۶۰٫۵ | ۶۲٫۱ | ۶۵٫۳ | ۶۵٫۶ |
| AutomationBench-AA | ۴۵٫۴ | ۳۹٫۱ | ۳۲٫۱ | ۴۱٫۶ | ۴۱٫۲ |
| GDP.pdf | ۳۳٫۲ | ۳۰٫۸ | ۲۷٫۶ | ۳۴٫۲ | ۳۰٫۶ |
| JobBench | ۷۵٫۳ | ۷۰٫۵ | ۷۳٫۱ | ۶۶٫۱ | ۷۵٫۴ |
| OSWorld V2.1 | ۷۸٫۴ جزئی / ۳۹٫۴ کامل | ۷۲٫۶ جزئی / ۳۴٫۳ کامل | ۸۰٫۷ جزئی / ۴۳٫۱ کامل | ۷۵٫۸ جزئی / ۳۴٫۳ کامل | ۸۱٫۸ جزئی / ـ کامل |
| MemoryBench | ۸۵٫۵ | ۸۵٫۶ | ۷۹٫۰ | ۸۱٫۴ | ۸۱٫۵ |
| Terminal-Bench 4.0-AA | ۵۷٫۱ | ۵۲٫۰ | ۵۲٫۰ | ۵۹٫۱ | ۵۹٫۶ |
| DeepSWE 1.1 | ۷۹٫۰ | ۷۸٫۸ | ۶۷٫۴ | ۷۴٫۱ | ۷۴٫۲ |
| SWE-Marathon | ۵۷٫۵ (xhigh) | ۵۳٫۱ | ۴۵٫۶ | ۴۲٫۵ | ۴۶٫۳ |
| ProgramBench | ۵۹٫۰ | ۵۰٫۰ | ۵۵٫۵ | ۵۲٫۵ | ۷۰٫۵ |
| Artificial Analysis Index | ۵۶ | ۵۲ | ۵۳ | ۵۳ | ۵۸ |
منبع جدول: متا، انتشار همراه رونمایی در ۱۲ اکتبر ۲۰۲۶، برابر با ۲۰ مهر ۱۴۰۵؛ بررسی صفحه در ۱۳ اکتبر ۲۰۲۶، برابر با ۲۱ مهر ۱۴۰۵. PSI و شاخص Artificial Analysis امتیاز شاخصاند؛ سایر ردیفها امتیاز درصدی دارند و مقدار بیشتر بهتر است. در OSWorld، «جزئی» امتیاز انجام بخشی از کار و «کامل» معیار موفقیت دودویی است. خط تیره یعنی داده گزارش نشده است.
هر آزمون و بنچمارک چه تواناییای را میسنجد؟
طبق کارت مدل هر آزمون و بنچمارک موارد زیر را مشخص میکند:
- PSI شاخص داخلی ترکیبی برای کارهای شخصی و حرفهای
- Harvey LAB-AA شاخص خروجی حقوقی
- Vals Finance Agent شاخص پژوهش مالی
- HealthBench Pro شاخص پاسخهای سلامت
- AutomationBench شاخص گردشکار کسبوکار
- آزمون GDP.pdf شاخص کار با منابع PDF
- JobBench شاخص وظایف شغلی
- OSWorld شاخص کار با محیط رایانه
- MemoryBench شاخص آزمون داخلی یادآوری
- Terminal-Bench شاخص وظایف ترمینال
- ، DeepSWE و SWE-Marathon شاخصهای پروژههای نرمافزاری
- ProgramBench شاخص بازسازی برنامه
تحلیل جدول بنچمارکها چه میگوید؟
جدول برتری یکسانی برای همه وظایف نشان نمیدهد. مثلاً واندر معمولی در MemoryBench بالاتر از فول است، درحالیکه فول در چند آزمون برنامهنویسی نتیجه بهتری دارد. بنابراین انتخاب نسخه باید با نوع کار انجام شود؛ واژه «فول» تضمین برد در هر آزمون نیست.
متا نتایج داخلی، نتایج شرکتهای سازنده و ارزیابیهای بیرونی را در جدول کنار هم گذاشته است. تنظیم رقبا در اجراهای داخلی، تا حد امکان مشترک بوده، اما الزاماً برای آنها بهینه نشده است. در SWE-Marathon، ابزار اجرای رقبا متفاوت است و فول با سطح xhigh گزارش شده؛ پس این ردیف مقایسه کاملاً کنترلشده با یک محیط یکسان نیست.
ارزیابی مستقل Artificial Analysis از Muse Wonder و Muse Wonder Full چه میگوید؟
گزارش مستقل Artificial Analysis در ۱۲ اکتبر ۲۰۲۶، برابر با ۲۰ مهر ۱۴۰۵، امتیاز شاخص هوش را برای واندر ۵۲ و فول ۵۶ اعلام کرده است؛ اسپارک ۱٫۳ در حالت حداکثری امتیاز ۴۸ داشت. این افزایش بهترتیب ۴ و ۸ امتیاز است، نه ۴ و ۸ درصد. فول در هر ده آزمون این شاخص نسبت به اسپارک پیشرفت کرده است.
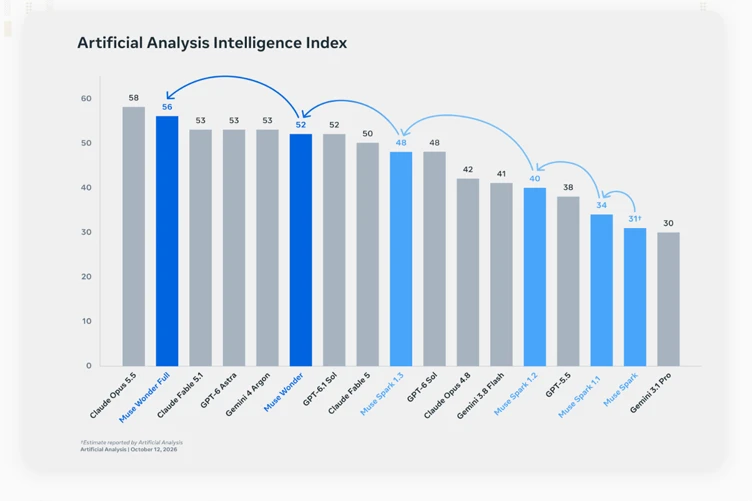
در همان گزارش، هزینه هر وظیفه شاخص برای واندر ۴٫۵۲ دلار و برای اسپارک ۱٫۶۰ دلار است؛ برای فول هزینهای بر مبنای توکن ارائه نشده است. دانش همچنان ضعف نسبی این خانواده است و نتیجه بهتر در اجرای کارها را نباید معادل دانستن پاسخ همه پرسشها گرفت.
یک اختلاف نیازمند توجه است: گزارش مستقل برای AutomationBench-AA نسخه معمولی و فول، ۶۸٪ و ۷۱٪ آورده، اما جدول متا ۳۹٫۱ و ۴۵٫۴ نشان میدهد. علت این اختلاف در منابع بررسیشده روشن نیست؛ از همین رو اعداد دو منبع جدا نقل شدهاند. شرایط اجرای آزمون و نسخه ارزیابی باید پیش از نتیجهگیری بررسی شوند.
قیمت مدل Muse Wonder؛ نحوه دسترسی و استفاده
قیمت رابط برنامهنویسی (API) میوز واندر در صفحه رسمی تعرفهها بر مبنای هر یک میلیون توکن محاسبه میشود. توکن واحد پردازش متن است و لزوماً برابر با یک کلمه نیست. جدول زیر همان جدول تعرفه منتشرشده برای مدل muse-wonder-1.0 است.
| نوع مصرف | حالت استاندارد دلار بهازای یک میلیون توکن | حالت مشارکتی |
| ورودی کششده | ۰٫۲۰ | ارائه نمیشود |
| ورودی | ۴٫۰۰ | ارائه نمیشود |
| خروجی | ۲۰٫۰۰ | ارائه نمیشود |
منبع قیمت: مستندات رسمی متا؛ بررسی در ۱۳ اکتبر ۲۰۲۶، برابر با ۲۱ مهر ۱۴۰۵. تاریخ مستقل اجرای تعرفه در صفحه مشخص نیست. برای ورودی طولانی هزینه اضافه اعلام نشده؛ جستوجوی وب جداگانه ۲٫۵۰ دلار بهازای هزار درخواست هزینه دارد. قیمت استاندارد اسپارک ۱٫۳، ۱٫۲۵ دلار ورودی، ۰٫۱۵ دلار ورودی کششده و ۴٫۲۵ دلار خروجی است؛ بنابراین واندر در این سه جزء گرانتر است. این ارقام تعرفه متا هستند و قیمت هوشا یا سرویس واسطه محسوب نمیشوند.
نسخه فول تعرفه عمومی مستقل بهازای توکن ندارد و در اشتراکهای Power Usage و Maximum Usage ارائه میشود. صفحه رسمی محصول قیمت این پلنها را بهترتیب ماهانه ۵۰ و ۲۰۰ دلار نشان میدهد؛ بررسی در ۱۳ اکتبر ۲۰۲۶، برابر با ۲۱ مهر ۱۴۰۵. این مبلغ هزینه یک اشتراک با سقف مصرف است و قابل مقایسه مستقیم با قیمت هر میلیون توکن نیست.
نسخه معمولی در API و Muse Code عرضه شده، ولی راهنمای شروع متا آن را در وضعیت پیشنمایش (Preview) توصیف میکند. نسخه فول در API عمومی ارائه نمیشود. واندر قرار است بعداً وارد تجربه Muse شود و عرضه از مشترکان آغاز شود؛ زمان دقیق این مرحله اعلام نشده است.
Claude Code چیست؟ آموزش استفاده، قابلیتها، محدودیتها و هزینه
شرایط دسترسی منطقهای و استفاده از دادههای کاربر
شرایط اشتراک ممکن است با منطقه فرق کند و مزایای قابل ارائه هنگام ثبتنام نمایش داده میشوند. مستندات اشتراک داشتن حساب متا و رسیدن به سن مجاز را لازم میدانند؛ دسترسی مستقیم کاربران ایران از این منابع تأیید نمیشود.
حالت مشارکتی (Contributor Mode) در اشتراک Muse Code بهطور پیشفرض فعال است و به متا اجازه میدهد از محتوای ارسالی و پاسخها برای آموزش مدلهای آینده استفاده کند. کاربر میتواند آن را خاموش کند؛ پس از خاموشکردن، محتوای آینده برای آموزش استفاده نمیشود، مگر دوباره فعال شود. در حالت استاندارد (Standard Mode)، محتوا برای آموزش مدلهای متا استفاده نمیشود. اشتراک Muse Code نیز هزینه کلیدهای اضافی API را پوشش نمیدهد.
محدودیتها و ملاحظات ایمنی Muse Wonder و Muse Wonder Full
کارت مدل خطا در پاسخ، استدلال چندمرحلهای و درک فضایی، بهویژه وظایف سهبعدی، را از محدودیتها میداند. همه زبانهای موجود در داده آموزشی ارزیابی نشدهاند؛ نتیجه مشخصی برای کیفیت فارسی این خانواده در منابع بررسیشده پیدا نشد. تنظیمات سرویس، ابزارها و دستور کاربر هم روی عملکرد اثر میگذارند.
متا آموزش برای حفظ اطلاعات خصوصی و مقابله با سوءاستفاده را توضیح داده و در اعلام رسمی از انتشار گزارش تکمیلی ایمنی در آینده خبر میدهد. کارت مدل موجود نیز ارزیابی ریسک دارد؛ نباید این دو را یکی دانست. درباره عملکرد واقعی یک ایجنت، علاوه بر توان مدل باید مجوز ابزارها و امکان بازبینی اقدامهای مهم را بررسی کرد.
استفاده از مدلهای متنی متا و دیگر شرکتها در هوشا
برای کاربران ایرانی که میخواهند مدلهای متنی مختلف را در یک محیط فارسی استفاده کنند، هوشا دسترسی به Muse Spark 1.3، کلود، جمنای، گروک و جیپیتی را فراهم میکند. امکان استفاده از هوش مصنوعی آنلاین در یک حساب، پرداخت ریالی و دسترسی بدون نیاز به ویپیان از مزایای این پلتفرم است.
در کنار مدل متا، میتوانید از چت جی پی تی برای نگارش، تحلیل و کارهای متنی استفاده کنید. انتخاب مدل را با نیاز واقعی، کیفیت خروجی و هزینه انجام دهید؛ مقایسه چند خروجی روی یک وظیفه مشخص، برای تصمیم کاری شما مفیدتر از اتکا به یک رتبه عمومی است.
جمعبندی
میوز واندر و میوز واندر فول مسیر متا را به سمت عاملهایی با توان پیگیری کارهای طولانی ادامه میدهند. شواهد مستقل از پیشرفت نسبت به اسپارک ۱٫۳ حمایت میکنند، اما هزینه، تفاوت شرایط آزمون و ضعف نسبی در دانش، برای انتخاب مدل مهماند. ارزش عملی این خانواده را باید در تمامکردن یک وظیفه مشخص با خروجی قابل بررسی سنجید.
میوز واندر و میوز واندر فول چه زمانی معرفی شدند؟
متا آنها را در ۱۲ اکتبر ۲۰۲۶، برابر با ۲۰ مهر ۱۴۰۵، معرفی کرد و دسترسی اولیه نیز همان روز آغاز شد.
آیا میوز واندر رایگان است؟
تعرفه عمومی API مصرفی است و نسخه فول با اشتراک ارائه میشود؛ عرضه عمومی رایگان این دو مدل در منابع بررسیشده اعلام نشده است.
آیا میوز واندر و میوز واندر فول تصویر و ویدیو تولید میکنند؟
خروجی مدل متن است. توان دریافت تصویر و ویدیو به معنی تولید مستقیم این رسانهها نیست.
آیا اشتراک میوز کد مصرف همه کلیدهای API را پوشش میدهد؟
خیر. اشتراک برای مسیر Muse Code است؛ مصرف کلیدهای API اضافی جداگانه و بهصورت مصرفی محاسبه میشود.
 تبدیل فایل صوتی به متن با ChatGPT؛ آپلود مستقیم و تبدیل صدا به متن
 مدل Muse Wonder و Muse Wonder Full متا معرفی شدند! (ویدیوی رسمی)
 Claude Motion معرفی شد؛ ساخت موشنگرافیک و محتوای تعاملی با دستورات متنی
 Decision-1 مدل جدید مایکروسافت؛ تصمیمگیری ۳۵ برابر سریعتر از GPT-6 Sol
 هوش مصنوعی Qwen-Image-2.1-Turbo؛ تولید تصویر با ۸ مرحله پردازش

