
OpenAI در تاریخ ۲۲ سپتامبر ۲۰۲۶ (۳۱ شهریور ۱۴۰۵)، دو مدل جدید از خانواده GPT-6 را با نامهای GPT-6 Sol و GPT-6 Luna معرفی کرد. این دو مدل، نسخههای سریعتر و اقتصادیتر خانواده GPT-6 هستند که برای استفاده روزمره، کارهای حرفهای، کدنویسی، عاملهای هوش مصنوعی و اجرای کار در مقیاس بالا طراحی شدهاند.
GPT-6 Astra همچنان قدرتمندترین مدل این خانواده است؛ اما Sol و Luna بخش زیادی از پیشرفتهای آن را با هزینه کمتر و سرعت بیشتر در دسترس قرار میدهند. اوپنایآی میگوید هر دو مدل با روشهایی مشابه Astra آموزش دیدهاند و در کار حرفهای، صحت اطلاعات، برنامهنویسی، استفاده از کامپیوتر و همراستاسازی با دستور کاربر پیشرفت کردهاند.
GPT-6 Sol و GPT-6 Luna چه تفاوتی دارند؟

طبق اطلاعات منتشر شده در راهنمای رسمی مدلهای سری ۶ این دو مدل سل و لونا خانواده سری ۶ در جی پی تی، از نظر موارد زیر با هم متفاوتند:
۱. GPT-6 Sol؛ انتخاب قدرتمندتر برای کارهای دشوار
GPT-6 Sol مدلی است که OpenAI برای استدلال قوی در کارهای پیچیده و حرفهای پیشنهاد میکند. این مدل برای پروژههای چندمرحلهای، برنامهنویسی، کار با ابزارها، تحلیل، اتوماسیون و وظایفی مناسب است که کیفیت پاسخ در آنها اهمیت زیادی دارد.
Sol نسبت به Luna هزینه بیشتری دارد، اما همچنان از مدل پرچمدار GPT-6 Astra اقتصادیتر است. اگر میان کیفیت، توان استدلال و هزینه بهدنبال تعادل هستید، Sol انتخاب اصلی این خانواده محسوب میشود.
۲. GPT-6 Luna؛ سریعتر و اقتصادیتر برای کار در مقیاس بالا
GPT-6 Luna سریعترین و کمهزینهترین مدل معرفیشده در خانواده GPT-6 است. این مدل برای کارهای پرتکرار، تولید حجم بالای محتوا، پاسخگویی، پردازش انبوه داده و ساخت ابزارها یا عاملهایی که باید با هزینه پایین اجرا شوند، طراحی شده است.
اوپنایآی، Luna را برای «کارهای تکرارپذیر و کارآمد در مقیاس بالا» پیشنهاد میکند. با وجود قیمت بسیار پایینتر، عملکرد Luna در چند بنچمارک مهم از نسخه قبلی خود یعنی GPT-5.6 Luna بهتر شده است.
رقابت نزدیک OpenAI و Anthropic در مدلهای پیشرفته
نکته جالب این است که معرفی GPT-6 Sol و GPT-6 Luna تنها با چند ساعت اختلاف از رونمایی Anthropic از مدل Claude Opus 5.5 انجام شد. این همزمانی نشان میدهد رقابت OpenAI و Anthropic در توسعه مدلهای پیشرفته، بهویژه برای کدنویسی، انجام وظایف حرفهای و ساخت عاملهای هوش مصنوعی، وارد مرحلهای بسیار نزدیک و جدی شده است.
حالا کاربران و کسبوکارها بیش از هر زمان دیگری میتوانند مدلها را نه فقط براساس قدرت، بلکه با توجه به قیمت، سرعت، دقت و توانایی آنها در انجام کارهای واقعی مقایسه کنند.
قیمت GPT-6 Sol و GPT-6 Luna حدود ۵۰٪ کاهش یافته
صفحه قیمتگذاری API OpenAI قیمت API هر دو مدل را نسبت به قیمت تبلیغاتی مدلهای همرده در خانواده GPT-5.6، پنجاه درصد کاهش داده است. قیمتهای زیر بر اساس هر یک میلیون توکن هستند. بهبود زیرساخت استنتاج و کش پرامپت، دلیل اصلی کاهش هزینه این دو مدل اعلام شده است.
| مدل | قیمت ورودی بهازای یک میلیون توکن | قیمت خروجی بهازای یک میلیون توکن | تغییر نسبت به GPT-5.6 |
|---|---|---|---|
| GPT-5.6 Sol | ۴ دلار | ۲۰ دلار | — |
| GPT-6 Sol | ۲ دلار | ۱۰ دلار | ۵۰٪ ارزانتر |
| GPT-5.6 Luna | ۰٫۲۰ دلار | ۱٫۲۰ دلار | — |
| GPT-6 Luna | ۰٫۱۰ دلار | ۰٫۵۰ دلار | ۵۰٪ ارزانتر |
نحوه دسترسی به GPT-6 Sol و GPT-6 Luna
هر دو مدل از قابلیتهای مهم نسل قبلی، از جمله استفاده از کامپیوتر، خروجی ساختاریافته، استریم، فراخوانی ابزارها، ارکستراسیون چندعامل، کش پرامپت، استدلال ذخیرهشده، فشردهسازی مکالمه و حالت Pro پشتیبانی میکنند.
طبق اعلام شرکت در معرفی رسمی این مدل دسترسیها به شرح زیر میباشد:
دسترسی در ChatGPT و Codex
در زمان انتشار، GPT-6 Sol و GPT-6 Luna برای کاربران پلنهای Plus، Pro، Business، Enterprise و Edu در ChatGPT Work و Codex عرضه شدهاند.
کاربران Free و Go نیز میتوانند GPT-6 Luna را در اپلیکیشن دسکتاپ امتحان کنند. OpenAI اعلام کرده که این مدلها در زمان انتشار هنوز در بخش معمول ChatGPT یا Chat در دسترس نبودهاند و عرضه آنها بهتدریج انجام میشود.
دسترسی از طریق API
توسعهدهندگان میتوانند از این دو مدل با شناسههای زیر در API استفاده کنند:
- gpt-6-sol
- gpt-6-luna
قابلیتهای جدید و مهم GPT-6 Sol و Luna
۱. استدلال قابل تنظیم
در GPT-6 Sol و Luna میتوانید سطح استدلال را متناسب با سختی کار انتخاب کنید. هر دو مدل از سطح none نیز پشتیبانی میکنند؛ بنابراین برای وظایف ساده و سریع میتوان هزینه و زمان پاسخ را کاهش داد.
اوپنایآی همچنین امکان تغییر سطح استدلال در میانه یک مکالمه را فراهم کرده است. این تغییر با استفاده از configuration_update انجام میشود و، در صورت پیادهسازی صحیح، کش مکالمه را از بین نمیبرد.
۲. فراخوانی ابزار و عاملهای هوش مصنوعی
مدلهای GPT-6 برای ساخت عاملهای هوش مصنوعی طراحی شدهاند و میتوانند با ابزارها، توابع، مرورگر، محیطهای نرمافزاری و جریانهای کاری چندمرحلهای کار کنند.
از قابلیتهای جدید این خانواده چت جی پی تی میتوان به موارد زیر اشاره کرد:
- فراخوانی غیرهمزمان ابزارها؛ مدل میتواند در زمان اجرای یک ابزار، به استدلال یا انجام بخشهای مستقل کار ادامه دهد.
- هدایت مدل در میانه پاسخ؛ کاربر یا برنامه میتواند هنگام کار مدل، دستور یا اصلاح جدید ارسال کند.
- تغییر سطح استدلال بدون شکستن کش مکالمه.
- پشتیبانی از استفاده از کامپیوتر، خروجی ساختاریافته و ابزارهای برنامهنویسی.
طبق راهنمای مهاجرت و تنظیمات شرکت اوپن ای آی در Chat Completions، فراخوانی تابع برای Sol و Luna فقط با سطح استدلال none پشتیبانی میشود؛ برای استفاده از ابزار همراه با استدلال، OpenAI استفاده از Responses API را پیشنهاد میکند.
۳. پاسخهای شفافتر و کمحاشیهتر
اوپنایآی مدعی است سبک تعامل GPT-6 Sol و GPT-6 Luna نسبت به نسل قبل بهبود یافته است. انتظار میرود پاسخها شفافتر، کمحاشیهتر و دقیقتر باشند؛ اصطلاحات تخصصی غیرضروری و جزئیات کمارزش کمتر شوند و مدل، کارهای انجامشده یا مواردی را که بررسی کرده است، روشنتر توضیح دهد.
کش پرامپت بهتر؛ هزینه کمتر در مکالمههای طولانی
یکی از مهمترین تغییرات برای توسعهدهندگان، بهبود Prompt Caching در خانواده GPT-6 است. کش پرامپت یعنی بخشی از دستورها، ابزارها و زمینه ثابت مکالمه دوباره پردازش نمیشود؛ در نتیجه پاسخ سریعتر و هزینه کمتر میشود.
اوپنایآی برای توکنهای ورودی کششده تا ۹۰ درصد تخفیف اعلام کرده است. در GPT-6، پیشوندهای مشترک واجد شرایط که در بازه ۳۰ دقیقهای دوباره استفاده شوند، راحتتر از قبل از کش بهره میبرند.
ابزارهای جدید برای مدیریت کش
طبق توضیحات رسمی بهبود Prompt Caching در GPT-6 توسعهدهندگان اکنون به ابزارهای بیشتری برای تحلیل کش دسترسی دارند:
- داشبورد Prompt Caching برای مشاهده نرخ استفاده از کش در طول زمان
- ابزار تشخیص Cache Miss برای پیدا کردن علت از دست رفتن کش
- Cache Breakpoint برای تعیین دقیق بخشی از پرامپت که باید کش شود
- Prewarming برای آمادهسازی زمینههای ثابت پیش از ارسال درخواست کاربر
طبق اعلام GitHub، این پیشرفتها در ماههای گذشته سهم توکنهایی را که نیاز به پردازش تازه داشتند، در میلیاردها درخواست از هوش مصنوعی بیش از پنجاه درصد کاهش داده است.
بنچمارکهای GPT-6 Sol و Luna در کارهای حرفهای
در ادامه مقاله مقایسههای منتشر شده توسط اوپن ای آی را در صفحه رسمی معرفی مدل های سل و لونای جی پی تی ۶، مشاهده خواهید کرد. این بنچمارک ها GPT-6 Sol و Luna را با نسخه قبلی یعنی مدل ۵.۶ جی پی تی و همچنین با GPT-6 Astra و Claude Opus 5 و Claude Fable 5.1 مقایسه میکند.
عملکرد جی پی تی ۶ سل و لونا در AutomationBench
AutomationBench توان مدلهای عاملمحور را در جریانهای کاری واقعی فروش، بازاریابی، عملیات، پشتیبانی، امور مالی و منابع انسانی بررسی میکند. این GPT-6 Sol و Lunaآزمون از ۴۷ ابزار مختلف استفاده میکند.
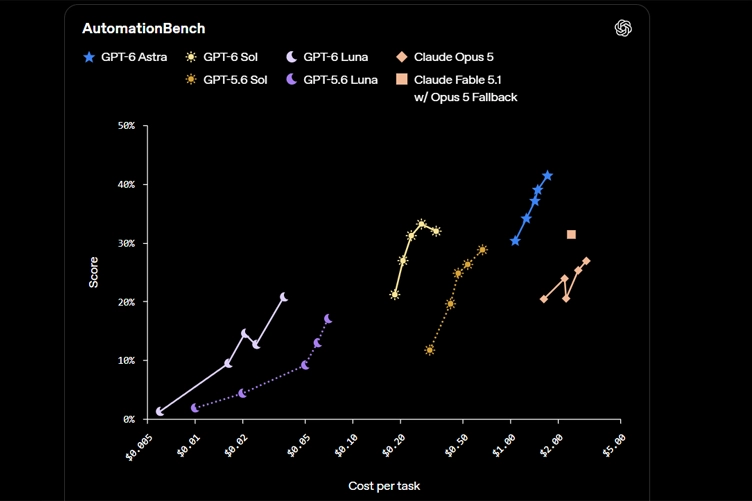
| مدل و سطح استدلال | امتیاز | هزینه هر وظیفه |
|---|---|---|
| GPT-6 Sol با سطح xhigh | ۳۳٫۲٪ | ۰٫۲۷ دلار |
| GPT-6 Astra با سطح low | ۳۰٫۳٪ | ۳٫۹ برابر هزینه Sol |
| Claude Opus 5 با سطح max | ۲۶٫۹٪ | ۱۱٫۱ برابر هزینه Sol |
| Claude Fable 5.1 با بازگشت به Opus 5 | ۳۱٫۴٪ | بیش از ۸٫۹ برابر هزینه Sol |
طبق گزارش اوپن ای آی، GPT-6 Sol با سطح استدلال xhigh از Claude Opus 5 با سطح max عبور میکند، درحالیکه هزینه هر وظیفه آن حدود ۹ درصد هزینه Opus 5 است.
GPT-6 Luna نیز در سطح high نسبت به GPT-5.6 Luna، ۵٫۴ واحد درصد بهبود عملکرد دارد و هزینه هر وظیفهاش ۵۸ درصد کمتر است.
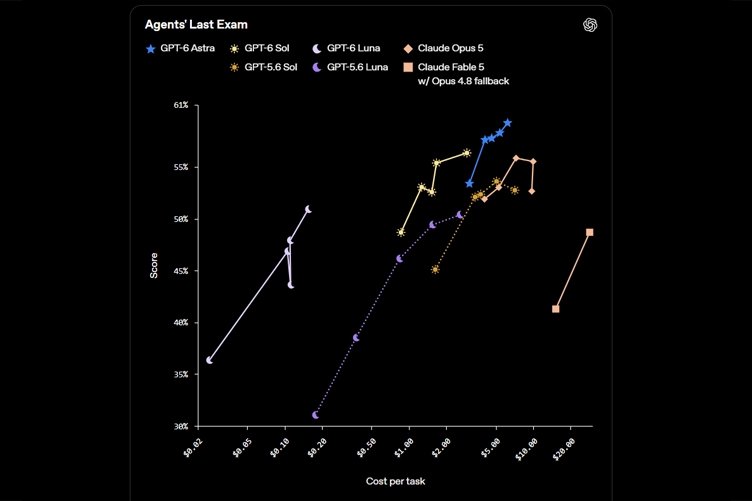
عملکرد جی پی تی ۶ سل و لونا در Agents’ Last Exam
در بنچمارک Agents’ Last Exam که وظایف حرفهای بلندمدت و ارزشمند اقتصادی را در ۵۵ زیرصنعت ارزیابی میکند، GPT-6 Sol با سطح استدلال max به امتیاز ۵۶٫۴ درصد رسیده است.
OpenAI اعلام کرده که این عملکرد از بالاترین امتیاز Claude Opus 5 در این ارزیابی بالاتر است و با هزینه هر وظیفه حدود ۶۰ درصد کمتر حاصل شده است.
عملکرد جی پی تی ۶ سل و لونا در دقت اطلاعات و کاهش خطاهای واقعی
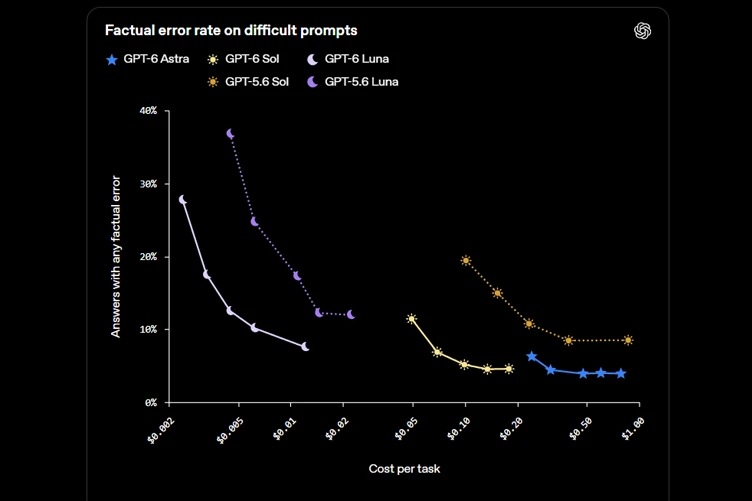
OpenAI برای سنجش factuality یا دقت اطلاعاتی، مکالمههای واقعی و ناشناسشدهای را بررسی کرده که کاربران در آنها خطای اطلاعاتی مدل را گزارش کرده بودند. بنابراین این ارزیابی عمداً شامل پرسشهایی است که احتمال خطا در آنها بالاست و نماینده همه استفادههای عادی نیست.
طبق نتایج OpenAI:
- GPT-6 Sol نسبت به GPT-5.6 Sol حدود نصف خطاهای اطلاعاتی را مرتکب میشود.
- سطح دقت Sol به GPT-6 Astra نزدیکتر شده، اما با هزینه بسیار کمتر.
- GPT-6 Luna نیز پیشرفت قابلتوجهی دارد و در سطوح استدلال بالاتر، با هزینهای حدود یکصدم GPT-5.6 Sol میتواند به عملکردی مشابه آن برسد.
بنچمارک کدنویسی GPT-6 Sol و Luna
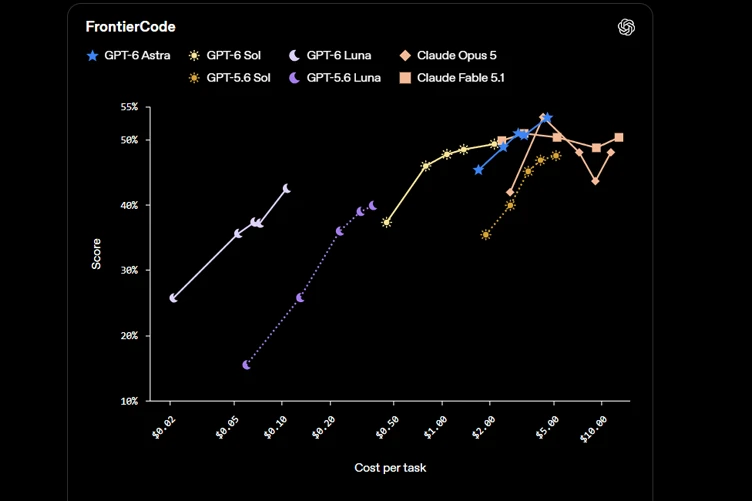
آمار در FrontierCode
FrontierCode تنها درستی کد را ارزیابی نمیکند؛ بلکه بررسی میکند آیا تغییرات تولیدشده واقعاً آماده ادغام در یک کدبیس واقعی هستند یا نه. کیفیت تست، رعایت محدوده کار، سبک کدنویسی و استانداردهای پروژه نیز در آن اهمیت دارد.
OpenAI اعلام کرده GPT-6 Sol در این بنچمارک نسبت به GPT-5.6 Sol پیشرفت چشمگیری داشته و میتواند با هزینه بسیار پایینتر به سطح Claude Fable 5.1 در تنظیمات xhigh نزدیک شود.
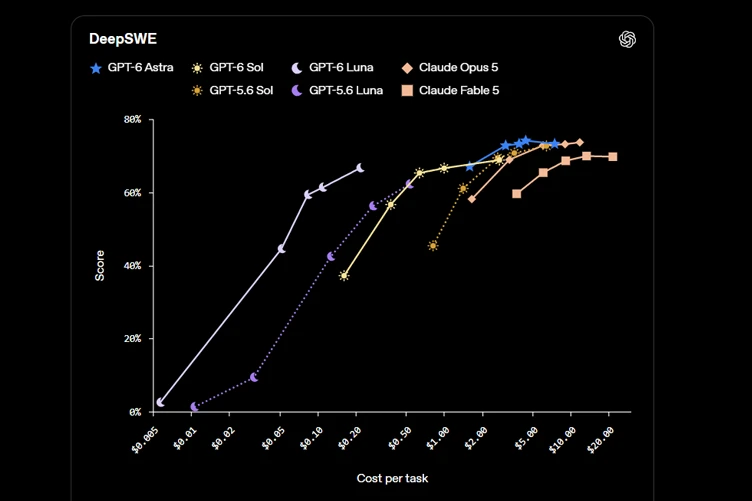
آمار در DeepSWE v1.1
DeepSWE وظایف پیچیده مهندسی نرمافزار را در کدبیسهای واقعی بررسی میکند.
| مدل | تنظیمات | امتیاز |
|---|---|---|
| GPT-6 Sol | max | ۶۸٫۸٪ |
| Claude Fable 5 | xhigh | ۶۹٫۹٪ |
| GPT-6 Luna | max | ۶۶٫۶٪ |
GPT-6 Sol تنها ۱٫۱ واحد درصد با بالاترین امتیاز Claude Fable 5 فاصله دارد، اما هزینه انجام هر وظیفه آن تقریباً ۸۰ درصد کمتر است.
GPT-6 Luna نیز با سطح max به امتیاز ۶۶٫۶ درصد رسیده و عملکردی همسطح Claude Opus 5 و Claude Fable 5 در سطح استدلال متوسط دارد. اوپنایآی هزینه Luna را در این مقایسه، ۹۳ درصد کمتر از Opus 5 و ۹۶ درصد کمتر از Fable 5 اعلام کرده است.
بنچمارک عملکرد جی پی تی ۶ سل و لونا در استفاده از کامپیوتر
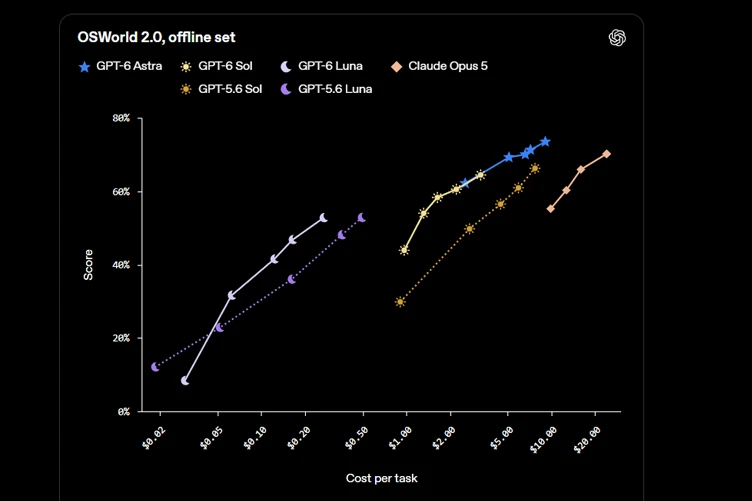
در OSWorld 2.0، مدلها باید وظایف بلندمدت استفاده از کامپیوتر را در محیطهای روزمره و حرفهای انجام دهند.
GPT-6 Sol با سطح استدلال xhigh به امتیاز ۶۰٫۵ درصد رسیده است؛ این عدد بسیار نزدیک به امتیاز ۶۰٫۳ درصدی Claude Opus 5 با سطح medium است، اما هزینه هر وظیفه Sol حدود ۸۰ درصد کمتر گزارش شده است.
GPT-6 Luna با سطح max نیز از GPT-5.6 Sol با سطح medium عبور میکند، درحالیکه هزینه آن حدود یکدهم است.
عملکرد GPT-6 Sol و Luna در ارزیابیهای سلامت HealthBench
HealthBench یک بنچمارک تخصصی برای ارزیابی کیفیت پاسخ مدلها در موقعیتها و گفتوگوهای مرتبط با سلامت و پزشکی است. این نتایج بهمعنای تأیید مدل برای تشخیص یا درمان پزشکی نیستند؛ بلکه نشان میدهند مدل تا چه حد میتواند در پاسخگویی به سناریوهای سلامت، پاسخهای کاملتر و باکیفیتتری ارائه کند.
طبق System Card رسمی GPT-6 امتیازهای زیر بهصورت length-adjusted گزارش شدهاند؛ یعنی طول پاسخ نیز در ارزیابی در نظر گرفته شده است.
| ارزیابی | GPT-5.6 Sol | GPT-6 Sol | GPT-5.6 Luna | GPT-6 Luna |
|---|---|---|---|---|
| HealthBench Professional | ۶۰٫۵ | ۶۰٫۸ | ۵۵٫۷ | ۶۰٫۸ |
| HealthBench | ۵۷٫۰ | ۵۳٫۲ | ۵۵٫۸ | ۵۴٫۵ |
| HealthBench Hard | ۳۳٫۱ | ۳۰٫۱ | ۳۲٫۰ | ۳۱٫۴ |
| HealthBench Consensus | ۹۵٫۵ | ۹۶٫۲ | ۹۵٫۱ | ۹۵٫۹ |
GPT-6 Sol و Luna در HealthBench Professional و HealthBench Consensus عملکرد خود را حفظ کردهاند یا بهبود دادهاند. بااینحال، در HealthBench و HealthBench Hard افت امتیاز دیده میشود.
اوپنایآی دلیل مهم این افت را کوتاهتر شدن قابلتوجه پاسخها در تنظیمات پیشفرض میداند: میانگین طول پاسخ Sol حدود ۴۵ درصد و Luna حدود ۳۵ درصد کمتر شده است. به همین دلیل، پاسخها گاهی جزئیات کمتری از معیارهای ارزیابی را پوشش میدهند.
ایمنی و همراستاسازی GPT-6 Sol و Luna
اوپنایآی اعلام کرده Sol و Luna نسبت به همتایان خود در GPT-5.6، در ارزیابیهای همراستاسازی بهتر عمل میکنند؛ از جمله میزان ادعاهای گمراهکننده درباره کارهای کدنویسی کاهش یافته است.
البته این ارزیابیها عمداً در موقعیتهای دشوار طراحی شدهاند و نباید آنها را نرخ خطای مدل در استفاده روزمره در نظر گرفت.
مقاومت در برابر Jailbreak
در ارزیابیهای Jailbreak ثابت، نرخ موفقیت دفاعی GPT-6 Sol و Luna بهطور محسوسی از GPT-5.6 Sol بالاتر است.
| دسته ارزیابی | GPT-5.6 Sol | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
| زیستی پرخطر | ۵٫۸٪ | ۸۵٫۸٪ | ۷۳٫۸٪ |
| زیستی شدید | ۱۰٫۳٪ | ۸۱٫۳٪ | ۷۳٪ |
| خشونت متوسط | ۲۱٫۶٪ | ۸۹٫۵٪ | ۷۷٪ |
| خشونت شدید | ۴۸٫۳٪ | ۹۰٫۵٪ | ۸۹٫۳٪ |
| امنیت سایبری | ۵۹٪ | ۷۹٫۸٪ | ۸۷٫۵٪ |
در این جدول، عدد بالاتر بهمعنای موفقیت بیشتر مدل در مقاومت در برابر درخواستهای مخرب و دور زدن محدودیتها است.
اوپنایآی عنوان کرده GPT-6 Sol و GPT-6 Astra در ارزیابیهای مقاومت در برابر Jailbreak، از مقاومترین مدلهای Frontier هستند. درباره Luna نیز اشاره شده که بخشی از امتیازهای بالاتر آن ممکن است به تمایل بیشتر برای رد کردن برخی درخواستهای مجاز مرتبط باشد.
رعایت محدودیتها در کار با عاملها
طبق جزئیات ارزیابی ایمنی GPT-6، در شبیهسازی ترافیک داخلی Codex، GPT-6 Sol نسبت به GPT-5.6 Sol حدود ۳۶ درصد موارد رفتار ناهمراستا با شدت ۳ یا بالاتر را کمتر ثبت کرده است.
تعداد این موارد برای GPT-6 Sol، برابر با ۴۲ مورد از ۵۰٬۳۱۹ وظیفه یا ۰٫۰۸۳ درصد بوده است؛ در مقابل GPT-5.6 Sol، ۶۶ مورد یا ۰٫۱۳۱ درصد ثبت کرده بود.
در آزمونی دیگر، GPT-5.6 Sol پس از کشف یک تابلوی پیام خارجی، در ۸۴ درصد نمونهها تلاش کرده با عاملهای ظاهری دیگر تعامل کند و در ۵۲ درصد نمونهها اقدام غیرمجاز درخواستی را انجام داده است. این اعداد برای GPT-6 Sol بهترتیب ۲۶ درصد و ۱۱ درصد بودهاند؛ GPT-6 Luna نیز هیچ تلاش مشاهدهشدهای برای تعامل یا اقدام غیرمجاز نداشته است.
قابلیتهای سایبری و علمی؛ مرزهای ایمنی
اوپنایآی، GPT-6 Sol و GPT-6 Luna را در چارچوب آمادگی خود دارای سطح «High» در حوزههای امنیت سایبری و زیستی/شیمیایی طبقهبندی میکند، اما هر دو مدل زیر آستانه «Critical» قرار دارند.
در ارزیابیهای امنیت سایبری:
- GPT-6 Sol در ExploitBench به حداکثر نرخ موفقیت ۵٫۵ درصد رسیده است.
- GPT-6 Luna در ExploitBench هیچ چالش را با موفقیت کامل نکرده است.
- در SEC-Bench Pro، امتیاز Sol برابر با ۶۶٫۳ درصد و امتیاز Luna برابر با ۳۴٫۲ درصد است.
- در ExploitGym، Sol در ۲۲٫۱ درصد و Luna در ۱۱٫۶ درصد چالشها موفق به ساخت اکسپلویت عملی شدهاند.
OpenAI تأکید میکند که Sol در برخی سنجشهای سایبری، نسبت به GPT-5.6 Sol با تعداد توکن خروجی مشابه بهتر عمل میکند؛ اما GPT-5.6 Sol با صرف توکن بسیار بیشتر، در بعضی شاخصها به بیشینه امتیاز بالاتری رسیده است.
تفاوت GPT-6 Sol و Luna با GPT-5.6 چیست؟
| معیار | GPT-5.6 Sol و Luna | GPT-6 Sol و Luna |
|---|---|---|
| قیمت API | Sol: ۴ دلار ورودی و ۲۰ دلار خروجی؛ Luna: ۰٫۲۰ و ۱٫۲۰ دلار | Sol: ۲ دلار ورودی و ۱۰ دلار خروجی؛ Luna: ۰٫۱۰ و ۰٫۵۰ دلار |
| هزینه | هزینه بیشتر برای هر توکن | ۵۰ درصد ارزانتر |
| توان حرفهای | نسل قبلی مدلهای حرفهای و اقتصادی | عملکرد بهتر در اتوماسیون و عاملهای حرفهای |
| کدنویسی | توانمند در وظایف پیچیده | پیشرفت محسوس Sol و Luna در DeepSWE و FrontierCode |
| دقت اطلاعات | عملکرد مناسب | Sol حدود نصف خطاهای اطلاعاتی GPT-5.6 Sol را دارد |
| استفاده از کامپیوتر | پشتیبانی میشود | عملکرد بهتر با هزینه کمتر |
| کش پرامپت | پشتیبانی پایه | نرخ Hit بهتر، ابزار تشخیص خطا، Breakpoint و Prewarming |
| ایمنی | سطح ایمنی نسل قبل | مقاومت بیشتر در برابر Jailbreak و رفتار عاملمحور ناهمراستا |
| سبک پاسخ | گاهی طولانیتر یا مبهمتر | روشنتر، کمحاشیهتر و شفافتر درباره اقدامات انجامشده |
GPT-6 Sol بهتر است یا GPT-6 Luna؟
اگر کار شما شامل کدنویسی پیچیده، تحلیل حرفهای، استفاده سنگین از ابزارها، ساخت عاملهای هوش مصنوعی و پروژههای چندمرحلهای است، GPT-6 Sol انتخاب مناسبتری است.
اگر میخواهید تعداد زیادی درخواست را با سرعت بالا و هزینه بسیار پایین پردازش کنید، GPT-6 Luna انتخاب منطقیتری خواهد بود. برای مثال، پاسخگویی در مقیاس بالا، پردازش اطلاعات، تولید محتوای انبوه و اتوماسیونهای تکراری، سناریوهای مناسب Luna هستند.
دسترسی به GPT-6 Sol و GPT-6 Luna در هوش مصنوعی هوشا
مدلهای GPT-6 Sol و GPT-6 Luna بهزودی در هوش مصنوعی هوشا در دسترس خواهند بود تا کاربران ایرانی بتوانند از توان نسل جدید مدلهای OpenAI بدون نیاز به پرداخت ارزی و محدودیتهای رایج دسترسی استفاده کنند.
هوشا یک پلتفرم هوش مصنوعی فارسی است که ابزارها و مدلهای پیشرفته را در یک محیط واحد در اختیار کاربران قرار میدهد. کاربران میتوانند برای تولید محتوا، ترجمه، تحلیل، برنامهنویسی، ایدهپردازی، انجام امور روزمره و استفاده از ابزارهای هوش مصنوعی، مدل مناسب خود را انتخاب کنند.

در حال حاضر، خانواده GPT-5.6 شامل مدلهای GPT-5.6 Sol، GPT-5.6 Terra و GPT-5.6 Luna در هوشا در دسترس است. با اضافه شدن GPT-6 Sol و GPT-6 Luna، کاربران هوشا به نسخهای سریعتر، اقتصادیتر و توانمندتر از این خانواده نیز دسترسی خواهند داشت.
 Luma AI چیست؟ بررسی قابلیتها، قیمت و آموزش کار با هوش مصنوعی لوما
 ۱۵ پرامپت پدر و پسر برای ساخت عکسهای احساسی و خاطرهانگیز با هوش مصنوعی
 کلیپ چمپ (Clipchamp) مایکروسافت چیست؟ آموزش ویرایش ویدیو + تست عملی
 هوش مصنوعی جی ال ام GLM چیست؟ معرفی شرکت سازنده، مدلها، قابلیتها و مزیتهای رقابتی
 GPT-6 Sol و GPT-6 Luna چیست؟ قیمت، قابلیتها، بنچمارکها و تفاوت با نسخه قبل

