
مدل کلود سونت Claude Sonnet 5.5 نسل جدید مدل متعادل آنتروپیک است که سرعت بیشتر، هزینه کمتر و عملکردی نزدیک به Claude Opus 5.5 را ارائه میدهد. این مدل در بعضی بنچمارکهای برنامهنویسی حتی از Opus 5.5 جلو افتاده و در چند آزمون مشترک نیز عملکرد بهتری از GPT‑6 Sol داشته است.
Anthropic این مدل را در تاریخ ۲۸ سپتامبر ۲۰۲۶ (۶ مهر ۱۴۰۵)، تنها ۶ روز پس از Claude Opus 5.5 معرفی کرد. بر اساس اطلاعات رسمی اعلام شده، مدل جدید بیش از ۳۰ درصد سریعتر از Sonnet 5 است و در بیشتر وظایف میتواند هزینه نهایی هر کار را تا ۳۰ درصد کاهش دهد.
کلود سونت Claude Sonnet 5.5 چیست؟

Claude Sonnet 5.5 دومین عضو خانواده Claude 5.5 محسوب میشود. نخستین مدل این خانواده، Claude Opus 5.5 بود که در ۲۲ سپتامبر معرفی شد و Anthropic قصد دارد Claude Haiku 5.5 را نیز در هفتههای آینده عرضه کند.
سونت ۵/۵ میان قدرت، سرعت و هزینه تعادل برقرار میکند. آنتروپیک مدل Opus 5.5 را برای پروژههای پیچیده، تصمیمگیریهای حساس و وظایف طولانی پیشنهاد میکند؛ در مقابل، سونت ۵/۵ برای کارهای روزمره، برنامهنویسی، برطرفکردن خطاها و ساخت اسناد، اسلایدها و فایلهای اکسل بهینه شده است.
به گفته Anthropic، این مدل نگاه بصری و طراحی قدرتمندی نیز دارد. سونت ۵/۵ میتواند رابطهای کاربری مرتبتری بسازد، قالب اسلایدها را بهتر رعایت کند و اسناد حرفهایتری تحویل دهد.
مشخصات کلاد سونت Claude Sonnet 5.5
بر اساس مستندات رسمی مدلهای Claude، Sonnet 5.5 از پنجره زمینه یکمیلیونتوکنی و خروجی حداکثر ۱۲۸ هزار توکنی پشتیبانی میکند. ورودی مدل میتواند شامل متن و تصویر باشد، اما خروجی آن متنی است.
| مشخصه | Claude Sonnet 5.5 |
|---|---|
| تاریخ معرفی | ۲۸ سپتامبر ۲۰۲۶ |
| شناسه در API | claude-sonnet-5-5 |
| پنجره زمینه | ۱ میلیون توکن |
| حداکثر خروجی | ۱۲۸ هزار توکن |
| ورودی | متن و تصویر |
| خروجی | متن |
| تاریخ پایان دادههای آموزشی | ژوئن ۲۰۲۶ |
| سطح تلاش پیشفرض در Claude Platform | High |
| سطح تلاش پیشفرض در برنامههای Claude | Medium |
| قیمت ورودی | ۲ دلار بهازای یک میلیون توکن |
| قیمت خروجی | ۱۰ دلار بهازای یک میلیون توکن |
پنجره زمینه یکمیلیونتوکنی به مدل اجازه میدهد حجم بالایی از کد، اسناد، گزارشها و سابقه مکالمه را در یک درخواست پردازش کند. البته داشتن پنجره زمینه بزرگ به این معنا نیست که مدل در تمام بخشهای یک متن بسیار طولانی دقت یکسانی خواهد داشت.
مهمترین قابلیتهای Claude Sonnet 5.5
۱. افزایش چشمگیر قدرت برنامهنویسی عاملمحور
مهمترین پیشرفت Claude Sonnet 5.5 در برنامهنویسی دیده میشود. این مدل میتواند یک پایگاه کد را بررسی کند، ابزارهای مختلف را به کار بگیرد، چند فایل را همزمان تغییر دهد و نتیجه کار خود را آزمایش کند.
Sonnet 5.5 در آزمون Terminal-Bench 4.0 امتیاز ۷۰٫۶ درصد را به دست آورده است؛ درحالیکه امتیاز Sonnet 5 تنها ۱۰٫۳ درصد بود. این جهش نشان میدهد نسخه جدید در انجام وظایف چندمرحلهای داخل محیط خط فرمان بهبود بسیار بزرگی داشته است.
Anthropic میگوید Sonnet 5.5 در مقایسههای رودررو، فراخوانی ابزارها را بیشتر بهصورت همزمان انجام میدهد. این رفتار تعداد مراحل انجام کار، مصرف توکن و زمان انتظار را کاهش میدهد.
۲. درک سریعتر پایگاههای کد
Sonnet 5.5 میتواند ساختار پروژههای نرمافزاری را سریعتر درک کند. آزمایشکنندگان اولیه اعلام کردهاند مدل برای رسیدن به نتیجه، به راهنماییهای جزئی کمتری نیاز دارد و در پروژههای چندفایلی بهتر در محدوده درخواست باقی میماند.
در آزمایشهای Lovable، مدل جدید برای تکمیل وظایف حدود یکسوم فراخوانی ابزار کمتر و تقریباً نصف اجرای دستورات شل را نیاز داشت. CodeRabbit نیز کاهش مصرف توکن و تصمیمگیری بهتر مدل در بررسی کد را گزارش کرده است.
۳. تولید اسناد، اسلاید و فایلهای اکسل
Claude Sonnet 5.5 فقط یک مدل برنامهنویسی نیست. Anthropic این مدل را برای تولید اسناد حرفهای، ارائهها، صفحات گسترده و رابطهای کاربری نیز بهینه کرده است.
در یکی از آزمایشهای داخلی Anthropic، اطلاعات مالی فصلی یک شرکت، متن جلسه گزارش درآمد و یک قالب اسلاید در اختیار مدل قرار گرفت. دو متخصص، نخستین نسخه ارائه ۱۰ اسلایدی تولیدشده توسط Sonnet 5.5 را بدون نیاز به ویرایش، آماده ارسال ارزیابی کردند.
۴. بهبود در کارهای طولانی و چندمرحلهای
Sonnet 5.5 در حفظ مسیر اصلی پروژه و انجام وظایف طولانی بهتر عمل میکند. این مدل میتواند مجموعهای از اقدامات وابسته به یکدیگر را انجام دهد و پس از هر مرحله، نتیجه را بررسی کند.
مدل جدید نخستین نسخه Sonnet است که توانسته بازی Pokémon Red را فقط با مشاهده اسکرینشاتها پیش ببرد. این آزمایش، ترکیبی از درک تصویر، حفظ وضعیت و تصمیمگیری بلندمدت را میسنجد.
۵. نگارش و همکاری طبیعیتر
Anthropic سبک نوشتاری Sonnet 5.5 را نیز بهبود داده است. مدل جدید اطلاعات مهم را زودتر بیان میکند، کمتر از اصطلاحات نامأنوس استفاده میکند و دستورهای مربوط به لحن و ساختار متن را دقیقتر رعایت میکند.
آزمایشکنندگان اولیه، این نسخه را همکار بهتری برای گفتوگو و انجام کارهای تکرارشونده توصیف کردهاند. سرعت بالاتر مدل نیز باعث میشود اصلاح چندمرحلهای متن، کد یا طراحی با وقفه کمتری انجام شود.
بنچمارکهای Claude Sonnet 5.5
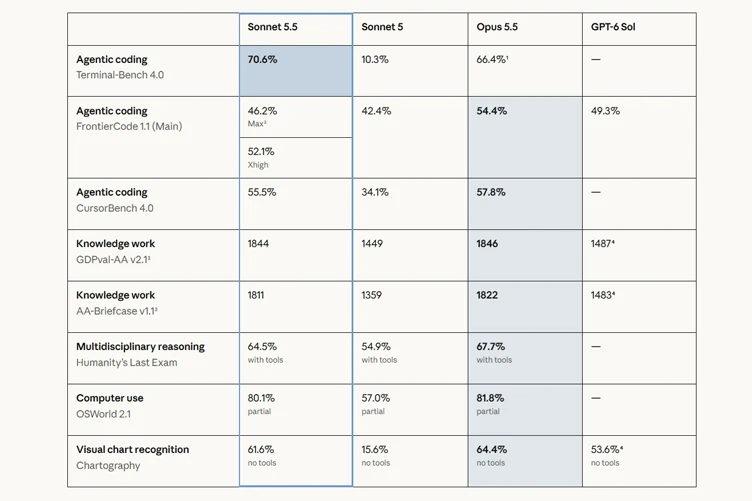
Anthropic نتایج Sonnet 5.5 را در چند آزمون برنامهنویسی، کارهای حرفهای، استدلال، کار با رایانه و درک نمودار منتشر کرده است. جدول زیر اعداد درجشده در گزارش رسمی بنچمارکهای این مدل را نشان میدهد.
بنچمارک عملکرد Sonnet 5.5 در کارهای حرفهای
در GDPval-AA، مدل Sonnet 5.5 امتیاز ۱۸۴۴ را ثبت کرده است؛ فقط دو امتیاز کمتر از Opus 5.5 و ۳۵۷ امتیاز بیشتر از GPT‑6 Sol. این آزمون وظایف واقعی ۴۴ شغل در ۹ صنعت را بررسی میکند.
در AA-Briefcase نیز Sonnet 5.5 با امتیاز ۱۸۱۱ فاصله کمی با امتیاز ۱۸۲۲ مدل Opus 5.5 دارد. GPT‑6 Sol در این آزمون امتیاز ۱۴۸۳ را کسب کرده است.
این نتایج نشان میدهند Sonnet 5.5 برای بسیاری از کارهای سازمانی، تحقیقاتی و تحلیلی به سطح Opus 5.5 نزدیک شده است؛ هرچند Anthropic همچنان Opus را برای کارهای باز، مبهم و نیازمند قضاوت طولانیمدت قویتر میداند.
عملکرد Sonnet 5.5 در کار با رایانه و تحلیل تصویر
Sonnet 5.5 در OSWorld 2.1 امتیاز ۸۰٫۱ درصد را به دست آورده است. این نتیجه فقط ۱٫۷ واحد درصد کمتر از Opus 5.5 و ۲۳٫۱ واحد درصد بیشتر از Sonnet 5 است.
در آزمون Chartography نیز امتیاز Sonnet 5.5 از ۱۵٫۶ به ۶۱٫۶ درصد رسیده است. این آزمون توانایی مدل را در خواندن و تحلیل نمودارها، بدون استفاده از ابزار جانبی، بررسی میکند.
Anthropic هشدار داده است که امتیاز منتشرشده GPT‑6 Sol در آزمونهای بصری ممکن است تحتتأثیر یک خطای قبلی در پردازش تصویر قرار گرفته باشد. OpenAI این مشکل چت جی پی تی را برطرف کرده، اما همه بنچمارکهای شخص ثالث هنوز با نسخه اصلاحشده تکرار نشدهاند. به همین دلیل
نتایج بنچمارک برنامهنویسی چه چیزی را نشان میدهند؟
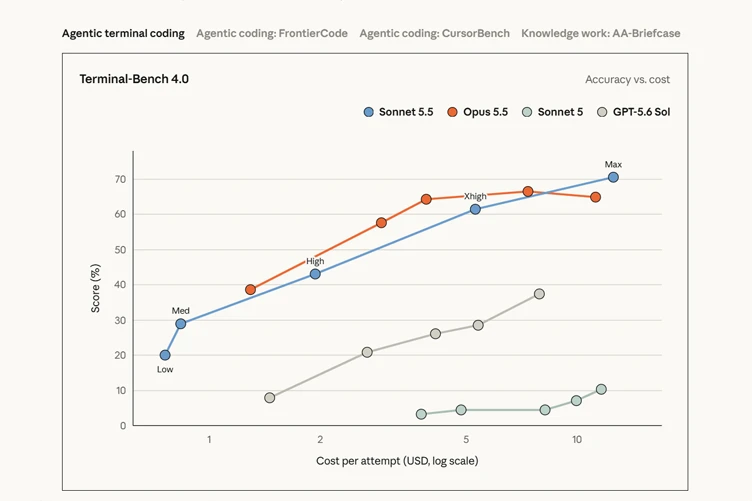
Sonnet 5.5 در Terminal-Bench 4.0 با امتیاز ۷۰٫۶ درصد، بالاتر از امتیاز ۶۶٫۴ درصدی Opus 5.5 قرار گرفته است. این آزمون توانایی مدل در اجرای وظایف حرفهای و چندمرحلهای در محیط خط فرمان را بررسی میکند.
در FrontierCode، بهترین نتیجه Sonnet 5.5 در سطح Xhigh برابر با ۵۲٫۱ درصد بوده است. این عدد از GPT‑6 Sol با امتیاز ۴۹٫۳ درصد بیشتر، اما از Opus 5.5 با امتیاز ۵۴٫۴ درصد کمتر است.
نکته جالب این است که Sonnet 5.5 در سطح Max امتیاز پایینتر ۴۶٫۲ درصد را ثبت کرده است. Anthropic توضیح میدهد که مدل در این حالت بیشتر از فرایندهای چندعاملی بررسی کد استفاده کرده و در دو مورد، همین رفتار باعث پایان زمان آزمون یا ایجاد تغییرات خارج از محدوده درخواست شده است. بنابراین افزایش سطح تلاش همیشه به امتیاز بیشتر منجر نمیشود.
تجربه شرکتها از کار با Claude Sonnet 5.5
آزمایشهای اولیه شرکتها نشان میدهند بهبود Sonnet 5.5 فقط به بنچمارکهای عمومی محدود نیست. البته این نتایج در محیطها و آزمونهای اختصاصی شرکتها به دست آمدهاند و نباید مانند یک بنچمارک مستقل و عمومی تفسیر شوند.
- Slack در آزمایشهای داخلی خود حدود ۱۴ درصد کاهش مصرف توکن خروجی و بهبود نتیجه در بیشتر آزمونهای Slackbot را گزارش کرده است.
- Zendesk اعلام کرده تیکتهای پشتیبانی با Sonnet 5.5 حدود ۲۰ درصد سریعتر پردازش شدهاند.
- شرکت Balyasny در ۲۴۴۱ وظیفه مالی، مصرف متوسط حدود ۱۲۱ هزار توکن برای هر پاسخ را ثبت کرده است؛ درحالیکه Sonnet 5 برای همان نوع کار حدود ۴۹۷ هزار توکن مصرف میکرد.
- Box اعلام کرده مدل جدید در آزمایشهایش ۲٫۴ برابر سریعتر بوده و ۱۲ درصد توکن کمتری مصرف کرده است.
- Base44 در ساخت ۱۱۸ اپلیکیشن، عملکردی همسطح Opus 5 ثبت کرده؛ اما Sonnet 5.5 بهطور متوسط با ۳٫۶ بار تکرار به نتیجه رسیده است، درحالیکه Opus 5 به ۷٫۷ بار تکرار نیاز داشت.
- Unity اعلام کرده Sonnet 5.5 حدود ۹۰ درصد وظایف بنچمارک چندمرحلهای و برنامهنویسی این شرکت را تکمیل کرده است.
این نتایج در گزارش رسمی Anthropic و به نقل از آزمایشکنندگان اولیه منتشر شدهاند.
مقایسه Claude Sonnet 5.5 و Opus 5.5
تفاوت اصلی Sonnet 5.5 و Opus 5.5 در سطح پیچیدگی کار است. Sonnet برای وظایف مشخص، تکرارشونده و حساس به هزینه مناسبتر است؛ درحالیکه Opus برای پروژههای پیچیده، مبهم و طولانی طراحی شده است.
اطلاعات قیمت و جایگاه Opus در صفحه رسمی این مدل منتشر شده است.
| معیار | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| جایگاه | تعادل سرعت، قدرت و هزینه | مدل قدرتمندتر برای کارهای پیچیده |
| وظایف مناسب | برنامهنویسی روزمره، رفع خطا، اسناد و طراحی | پروژههای طولانی، تحلیل عمیق و تصمیمگیری حساس |
| سرعت نسبی | سریع | متوسط |
| پنجره زمینه | ۱ میلیون توکن | ۱ میلیون توکن |
| حداکثر خروجی | ۱۲۸ هزار توکن | ۱۲۸ هزار توکن |
| قیمت ورودی | ۲ دلار | ۴ دلار |
| قیمت خروجی | ۱۰ دلار | ۲۰ دلار |
| خواندن کش | ۰٫۲۰ دلار | ۰٫۲۰ دلار |
| نوشتن کش | ۲٫۵۰ دلار | ۵ دلار |
در بیشتر بنچمارکها Opus 5.5 همچنان جلوتر است، اما فاصله دو مدل محدود شده است. Sonnet 5.5 در Terminal-Bench 4.0 از Opus جلو افتاده و در GDPval-AA، AA-Briefcase و OSWorld نیز بسیار نزدیک به آن ظاهر شده است.
با وجود این اعداد، خود Anthropic تأکید میکند که Opus 5.5 برای پروژههای باز و پیچیدهای که به قضاوت مداوم نیاز دارند، همچنان مدل قویتری است.
قیمت Sonnet 5.5 در برابر Opus 5.5
قیمت ورودی و خروجی Sonnet 5.5 دقیقاً نصف Opus 5.5 است. بااینحال، قیمت خواندن اطلاعات از کش در هر دو مدل برابر با ۰٫۲۰ دلار بهازای یک میلیون توکن است. این موضوع میتواند در عاملهای هوش مصنوعی و مکالمات طولانی، اختلاف هزینه واقعی دو مدل را کمتر کند.
مقایسه Claude Sonnet 5.5 با خانواده GPT‑6
خانواده GPT‑6 شامل سه مدل Astra و Sol و Luna است. طبق راهنمای رسمی مدلهای OpenAI، Astra قدرتمندترین عضو خانواده، Sol گزینه متعادل و Luna مدل اقتصادی برای پردازشهای پرتعداد است.
| مدل | جایگاه اصلی | پنجره زمینه | حداکثر خروجی | ورودی | خروجی |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | سرعت و هوشمندی متعادل | ۱ میلیون | ۱۲۸ هزار | ۲ دلار | ۱۰ دلار |
| Claude Opus 5.5 | کارهای پیچیده و طولانی | ۱ میلیون | ۱۲۸ هزار | ۴ دلار | ۲۰ دلار |
| GPT‑6 Astra | دشوارترین پروژههای سرتاسری | ۱٫۰۵ میلیون | ۱۲۸ هزار | ۱۰ دلار | ۵۰ دلار |
| GPT‑6 Sol | برنامهنویسی و عاملهای هوشمند | ۱٫۰۵ میلیون | ۱۲۸ هزار | ۲ دلار | ۱۰ دلار |
| GPT‑6 Luna | وظایف متمرکز و پرتعداد | ۱٫۰۵ میلیون | ۱۲۸ هزار | ۰٫۱۰ دلار | ۰٫۵۰ دلار |
قیمتها بهازای یک میلیون توکن و مربوط به پردازش استاندارد در محدوده زمینه کوتاه هستند. در مدلهای GPT‑6، درخواستهایی با بیش از ۲۷۲ هزار توکن ورودی با ضریب بیشتر محاسبه میشوند؛ نرخ ورودی و کش دو برابر و نرخ خروجی ۱٫۵ برابر میشود. Anthropic برای استفاده از پنجره یکمیلیونتوکنی Claude چنین افزایش قیمتی در نرخ استاندارد اعلام نکرده است.
مقایسه Sonnet 5.5 با GPT‑6 Sol
Sonnet 5.5 و GPT‑6 Sol از نظر قیمت مستقیم API دقیقاً همردهاند. هر دو مدل بهازای یک میلیون توکن ورودی ۲ دلار، خروجی ۱۰ دلار، خواندن کش ۰٫۲۰ دلار و نوشتن کش ۲٫۵۰ دلار هزینه دارند.
در چهار بنچمارکی که برای هر دو مدل نتیجه منتشر شده است، Sonnet 5.5 با بهترین تنظیم ثبتشده امتیاز بالاتری دارد:
- FrontierCode: امتیاز ۵۲٫۱ در برابر ۴۹٫۳ درصد
- GDPval-AA: امتیاز ۱۸۴۴ در برابر ۱۴۸۷
- AA-Briefcase: امتیاز ۱۸۱۱ در برابر ۱۴۸۳
- Chartography: امتیاز ۶۱٫۶ در برابر ۵۳٫۶ درصد
در FrontierCode، نتیجه سونت به سطح تلاش انتخابشده وابسته است. این مدل در Xhigh امتیاز ۵۲٫۱ و در Max امتیاز ۴۶٫۲ درصد گرفته است. بنابراین نمیتوان گفت Sonnet در تمام تنظیمات از Sol قویتر است.
GPT‑6 Sol از پنجره زمینه کمی بزرگتر ۱٫۰۵ میلیونتوکنی برخوردار است و به ابزارهایی مانند جستوجوی وب، جستوجوی فایل، اجرای کد و کنترل رایانه در Responses API دسترسی دارد. OpenAI نیز این مدل را بهطور خاص برای برنامهنویسی پیچیده و گردشکارهای عاملمحور معرفی کرده است. مشخصات آن در OpenAI API در دسترس است.
مقایسه Sonnet 5.5 با GPT‑6 Astra
GPT‑6 Astra رقیب مستقیم Sonnet 5.5 از نظر قیمت نیست. ورودی و خروجی Astra پنج برابر Sonnet قیمت دارند و OpenAI آن را برای پیچیدهترین پروژههای سرتاسری، تحقیق، برنامهنویسی، کار با رایانه و ساخت اسناد حرفهای عرضه کرده است.
Anthropic در جدول Sonnet 5.5 نتیجه مقایسه مستقیمی با Astra منتشر نکرده است. بااینحال، نتایج قبلی گزارش رسمی Opus 5.5 نشان میدهد رقابت میان مدلهای Claude 5.5 و Astra بسته به نوع آزمون تغییر میکند. برای نمونه، Opus 5.5 در Terminal-Bench 4.0 امتیاز ۶۶٫۴ درصد و Astra امتیاز ۵۷٫۹ درصد گرفتهاند؛ اما Astra در Terminal-Bench Science با امتیاز ۶۴٫۶ درصد بالاتر از امتیاز ۵۸٫۷ درصدی Opus قرار گرفته است.
بنابراین نباید بر اساس یک بنچمارک، یکی از این مدلها را در همه کاربردها برتر دانست. Astra برای کارهای بسیار پیچیده و چندرشتهای طراحی شده، درحالیکه مزیت اصلی Sonnet 5.5 ارائه عملکرد نزدیک به مدلهای ردهبالا با قیمت پایینتر است.
مقایسه Sonnet 5.5 با GPT‑6 Luna
GPT‑6 Luna یک مدل اقتصادی برای وظایف مشخص و پرتعداد است. قیمت ورودی آن ۰٫۱۰ دلار و قیمت خروجی آن ۰٫۵۰ دلار بهازای یک میلیون توکن است؛ یعنی Sonnet 5.5 در نرخ پایه، ۲۰ برابر گرانتر است.
OpenAI برای Luna نیز پنجره زمینه ۱٫۰۵ میلیونتوکنی، خروجی ۱۲۸ هزار توکنی و امکان تنظیم سطح تلاش از None تا Max را ارائه میدهد. بااینحال، Luna بیشتر برای دستهبندی، استخراج اطلاعات، پاسخگویی پرتعداد و وظایف مشخص مناسب است؛ درحالیکه Sonnet 5.5 برای کدنویسی، تحلیل حرفهای، طراحی و پروژههای چندمرحلهای جایگاه بالاتری دارد.
در حال حاضر مجموعه کاملی از نتایج مشترک و همشرایط میان Sonnet 5.5 و GPT‑6 Luna منتشر نشده است. به همین دلیل مقایسه قطعی کیفیت این دو مدل فقط بر اساس قیمت یا آزمونهای متفاوت، قابلاعتماد نیست. مشخصات کامل Luna در صفحه رسمی GPT‑6 Luna منتشر شده است.
قیمت Claude Sonnet 5.5
Anthropic قیمت پایه Sonnet 5.5 را نسبت به Sonnet 5 تغییر نداده است. قیمتها در مستندات رسمی Claude Platform بهصورت زیر اعلام شدهاند:
| نوع مصرف | قیمت هر یک میلیون توکن |
|---|---|
| توکن ورودی | ۲ دلار |
| توکن خروجی | ۱۰ دلار |
| خواندن از کش | ۰٫۲۰ دلار |
| نوشتن کش پنجدقیقهای | ۲٫۵۰ دلار |
| نوشتن کش یکساعته | ۴ دلار |
| پردازش گروهی ورودی | ۱ دلار |
| پردازش گروهی خروجی | ۵ دلار |
ثابتماندن قیمت هر توکن به این معنا نیست که هزینه نهایی هر وظیفه نیز ثابت است. Sonnet 5.5 برای انجام بسیاری از کارها به توکنها و مراحل کمتری نیاز دارد؛ به همین دلیل Anthropic کاهش هزینه تا ۳۰ درصد در هر وظیفه را گزارش کرده است.
پردازش گروهی یا Batch API نیز هزینه توکنهای ورودی و خروجی را ۵۰ درصد کاهش میدهد. این روش برای درخواستهایی مناسب است که به پاسخ فوری نیاز ندارند.
سرعت Claude Sonnet 5.5
Claude Sonnet 5.5 بیش از ۳۰ درصد سریعتر از Sonnet 5 خروجی تولید میکند. Anthropic آن را سریعترین مدل Sonnet عرضهشده تا امروز معرفی کرده است.
سرعت بالاتر فقط به تعداد توکن تولیدشده در ثانیه محدود نمیشود. مدل جدید با انجام همزمان فراخوانی ابزارها و استفاده از مراحل کمتر، زمان کلی رسیدن به نتیجه را نیز کاهش میدهد.
کاربر میتواند با تنظیم سطح Effort میان سرعت، هزینه و کیفیت تعادل ایجاد کند. سطح Medium در برنامههای Claude و Claude Code پیشفرض است؛ اما Claude Platform بهصورت پیشفرض از سطح High استفاده میکند.
ایمنی و محدودیتهای Claude Sonnet 5.5
Anthropic در ارزیابی رفتاری خود حدود ۱۸۵۰ سناریو را بررسی کرده است. Sonnet 5.5 در بیشتر معیارهای همراستایی، صداقت و مقاومت در برابر سوءاستفاده، عملکردی برابر یا بهتر از Sonnet 5 داشته است؛ بااینحال Opus 5.5 در مجموع کمی بهتر ارزیابی شده است.
۱. محدودیتهای امنیت سایبری
توانایی امنیت سایبری Sonnet 5.5 به Opus 5 نزدیک شده است. به همین دلیل، این مدل نخستین نسخه Sonnet است که همراه با محافظهای امنیت سایبری مدلهای قدرتمندتر Anthropic عرضه میشود.
این محدودیتها مانع برنامهنویسی عادی، شناسایی خطا یا رفع آسیبپذیریهای معمول نمیشوند. در درخواستهای امنیتی پرخطر، سیستم ممکن است پردازش را به Sonnet 5 منتقل کند.
۲. محافظهای زیستشناسی
محافظهای زیستشناسی Sonnet 5.5 مشابه Sonnet 5 هستند. بیشتر فعالیتهای آموزشی، پژوهشی و بالینی تحتتأثیر قرار نمیگیرند؛ اما ممکن است برخی درخواستهای تخصصی میکروبشناسی یا ویروسشناسی بهاشتباه محدود شوند.
۳. مقابله با استخراج توانایی مدل
Sonnet 5.5 نخستین مدل Sonnet است که با طبقهبندهای مخصوص مقابله با استخراج استدلال عرضه میشود. این محافظها برای جلوگیری از حملات Distillation طراحی شدهاند؛ حملاتی که در آن مهاجمان با تعداد زیادی حساب جعلی تلاش میکنند تواناییهای یک مدل را در مقیاس صنعتی استخراج و به مدل دیگری منتقل کنند.
Anthropic همچنین قابلیت Preserved Thinking را گسترش داده است. در نتیجه، بخشهای مربوط به فرایند استدلال مدل به حساب ایجادکننده مکالمه متصل میمانند و نمیتوان آنها را بهسادگی میان حسابهای مختلف جابهجا کرد. جزئیات این تغییرات در صفحه رسمی معرفی مدل آمده است.
نحوه دسترسی به Claude Sonnet 5.5 و استفاده از آن
Claude Sonnet 5.5 در تمام پلتفرمهای Anthropic و از طریق Claude Platform در دسترس قرار گرفته است. این مدل همچنین در Amazon Web Services، Google Cloud و Microsoft Azure ارائه میشود.
توسعهدهندگان میتوانند با شناسه claude-sonnet-5-5 از آن استفاده کنند. Sonnet 5.5 مانند Sonnet 5 و Opus 5.5 با گزینه نگهداری صفر دادهها یا Zero Data Retention نیز عرضه شده است.
توسعهدهندگانی که Sonnet را بدون قابلیت Thinking اجرا میکردند، هنگام مهاجرت باید از تنظیم جدید between_tools استفاده کنند. این تنظیم، استدلال اولیه را خاموش نگه میدارد؛ اما به مدل اجازه میدهد میان فراخوانی ابزارها فکر کند.
Claude Sonnet 5.5 برای چه کارهایی مناسب است؟
Sonnet 5.5 انتخاب مناسبی برای کارهایی است که به کیفیت بالا، سرعت زیاد و هزینه کنترلشده نیاز دارند:
- برنامهنویسی و رفع خطاهای نرمافزاری
- بررسی و بازنویسی کد
- ساخت رابط کاربری و صفحات وب
- تولید و ویرایش اسناد حرفهای
- ساخت ارائه و فایلهای اکسل
- تحلیل گزارشهای مالی و سازمانی
- بررسی نمودار، تصویر و اسناد
- عاملهای هوش مصنوعی پرتعداد
- پشتیبانی مشتری و پردازش تیکتها
- استخراج و تحلیل اطلاعات از اسناد طولانی
برای پروژههایی که بسیار مبهم، طولانی یا حساس هستند و به قضاوت مداوم نیاز دارند، Opus 5.5 همچنان انتخاب مطمئنتری است. برای پردازشهای ساده و بسیار پرتعداد نیز مدلهایی مانند GPT‑6 Luna میتوانند هزینه بسیار کمتری داشته باشند.
آیا Claude Sonnet 5.5 بهتر از Opus 5.5 و GPT‑6 است؟
Claude Sonnet 5.5 در همه زمینهها قویتر از Opus 5.5 یا تمام مدلهای GPT‑6 نیست. مزیت اصلی آن، نزدیککردن عملکرد مدلهای ردهبالا به سطح قیمت یک مدل متعادل است.
در مقایسه با Opus 5.5، مدل Sonnet تقریباً نصف قیمت را دارد و در بعضی بنچمارکها فاصله بسیار کمی با آن ثبت کرده است. بااینحال Opus همچنان برای پروژههای پیچیده و نیازمند قضاوت عمیق مناسبتر است.
در مقایسه با GPT‑6 Sol، قیمت دو مدل برابر است و Sonnet 5.5 در چهار آزمون مشترک منتشرشده، با بهترین تنظیم ثبتشده امتیاز بالاتری دارد. GPT‑6 Astra مدل قدرتمندتر و گرانتری است و GPT‑6 Luna نیز برای پردازشهای اقتصادی و پرتعداد طراحی شده است.
دسترسی به مدلهای Claude و سایر مدلهای هوش مصنوعی در هوشا
در سایت هوش مصنوعی فارسی هوشا میتوانید از مدلهای مختلف هوش مصنوعی در یک پلتفرم فارسی استفاده کنید و برای هر نوع کار، مدل مناسبتری را انتخاب کنید. هوشا دسترسی به مدلهای متنوع هوش مصنوعی برای گفتوگو، تولید محتوا، برنامهنویسی، تحلیل اطلاعات، ساخت تصویر، تولید ویدئو، ساخت موسیقی و تبدیل متن به صدا را فراهم کرده است.
در حال حاضر مدلهای Claude Opus 5 و Claude Opus 5.5 در هوشا در دسترس هستند. بنابراین کاربران میتوانند بدون نیاز به مراجعه مستقیم به سرویس خارجی، از تواناییهای مدلهای قدرتمند Claude برای کارهای تحلیلی، تولید محتوا، برنامهنویسی و انجام پروژههای حرفهای استفاده کنند.
جمعبندی
Claude Sonnet 5.5 یکی از مهمترین مدلهای متعادل Anthropic است. این مدل بیش از ۳۰ درصد سریعتر از Sonnet 5 است، قیمت پایه ۲ دلار برای ورودی و ۱۰ دلار برای خروجی دارد و در بسیاری از کارها با مصرف مراحل و توکن کمتر، هزینه نهایی را کاهش میدهد.
نتایج بنچمارکها نشان میدهند Sonnet 5.5 به Opus 5.5 بسیار نزدیک شده و در Terminal-Bench 4.0 حتی امتیاز بالاتری ثبت کرده است. این مدل در آزمونهای مشترک با GPT‑6 Sol نیز نتایج قابلتوجهی دارد؛ اما انتخاب نهایی باید بر اساس نوع وظیفه، سطح پیچیدگی، سرعت موردنیاز و هزینه انجام شود.
Claude Sonnet 5.5 بهتر است یا GPT‑6 Sol؟
هر دو مدل قیمت ورودی و خروجی یکسانی دارند. Sonnet 5.5 در چهار آزمون مشترک منتشرشده، با بهترین تنظیم ثبتشده امتیاز بالاتری کسب کرده است؛ اما انتخاب مناسب به نوع وظیفه و ابزارهای موردنیاز بستگی دارد.
Claude Sonnet 5.5 بهتر است یا Opus 5.5؟
Sonnet 5.5 سریعتر و ارزانتر است؛ اما Opus 5.5 برای وظایف پیچیده، مبهم و طولانی که به قضاوت عمیق نیاز دارند، انتخاب مناسبتری محسوب میشود.
پنجره زمینه Claude Sonnet 5.5 چقدر است؟
این مدل از پنجره زمینه یکمیلیونتوکنی و حداکثر خروجی ۱۲۸ هزار توکنی پشتیبانی میکند.
قیمت Claude Sonnet 5.5 چقدر است؟
قیمت هر یک میلیون توکن ورودی ۲ دلار و هر یک میلیون توکن خروجی ۱۰ دلار است. خواندن یک میلیون توکن از کش نیز ۰٫۲۰ دلار هزینه دارد.
Claude Sonnet 5.5 چه زمانی معرفی شد؟
Anthropic مدل Claude Sonnet 5.5 را در ۲۸ سپتامبر ۲۰۲۶ معرفی کرد.
 هوش مصنوعی دریمینا (Dreamina) | بررسی قابلیتها، محدودیتها و قیمت
 ایجنت هوش مصنوعی؛ از تعریف و کاربرد تا امنیت و هزینه AI Agent
 هوش مصنوعی پیکس ورس چیست؟ آموزش کامل PixVerse، قابلیتها و قیمت
 چت جی پی تی گو؛ امکانات، قیمت و مقایسه ChatGPT Go با پلن Plus
 معرفی GPT‑6.1 Sol؛ نزدیک به توان GPT‑6 Astra با هزینه کمتر

