
مدلهای Sync-3 و LipSync-2-Pro از ابزارهای هوش مصنوعی برای دوبله و هماهنگکردن حرکت لب با صدا هستند. این فناوری به تولیدکنندگان محتوا کمک میکند ویدیوها را دوبله کنند، دیالوگها را تغییر دهند و بدون فیلمبرداری مجدد، هماهنگی طبیعیتری میان صدا و تصویر ایجاد کنند.
تفاوت این دو مدل در نوع ورودی، پردازش نما و حفظ جزئیات چهره است. خبر خوب اینکه به زودی این مدلها به سرویس دوبله و صداگذاری پلتفرم هوشا اضافه خواهند شد.
در این مقاله میخوانید:
- قابلیتها و تفاوتهای Sync-3 و LipSync-2-Pro
- محدودیتهای هر مدل و کاربرد مناسب آنها
- مقایسه هزینه پردازش بر اساس ثانیه و دقیقه
- معرفی سرویسهای تبدیل متن به صدا و دوبله در هوشا
مدلهای sync-3 و lipsync-2-pro چیست؟
مدلهای Sync-3 و LipSync-2-Pro دو ابزار هوش مصنوعی از شرکت Sync Labs هستند. این ابزارها برای هماهنگکردن حرکت لب با فایل صوتی و ساخت ویدیوهای دوبلهشده استفاده میشوند.
تولیدکنندگان محتوا با استفاده از این مدلهای لیپسینک میتوانند دیالوگ ویدیو را تغییر دهند یا صدای یک زبان را جایگزین صدای اصلی کنند، بدون نیاز به فیلمبرداری مجدد از بازیگر یا گوینده.
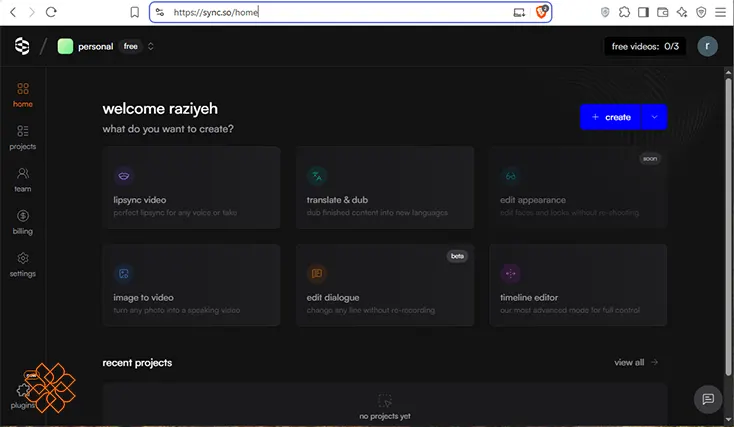
تفاوت مدلهای sync-3 و lipsync-2-pro چیست؟
تفاوت اصلی مدلهای Sync-3 و LipSync-2-Pro در نحوه پردازش تصویر، حفظ جزئیات چهره و مدیریت نماهای پیچیده است.
مسیر تولید ویدیوی دوبلهشده چیست؟
بهطور کلی، مسیر تولید ویدیوی دوبلهشده به صورت تبدیل متن به گفتار و در صورت نیاز ترجمه و دوبله و سپس ترکیب با ویدیو و هماهنگی لب است. (متن ← تولید گفتار ← ترکیب با ویدیو و هماهنگی لب)
- تبدیل متن به صدا (Text-to-Speech): متن نوشتهشده به گفتار تبدیل و یک فایل صوتی ساخته میشود.
- ترجمه و دوبله (Translation & Dubbing): دیالوگها به زبان مقصد ترجمه و با صدای جدید جایگزین صدای اصلی میشوند. برای ترجمه و تولید صدا ممکن است به ابزارهای جداگانه نیاز باشد.
- هماهنگی لب (Lip Sync): حرکت لبهای فرد در ویدیو با فایل صوتی جدید هماهنگ میشود. مدلهای Sync Labs در درجه اول برای این مرحله طراحی شدهاند و لزوماً خودشان ترجمه انجام نمیدهند.
نکته: توجه داشته باشید که ورودی صوتی با تولید صدا متفاوت است. اگر فایل صوتی آماده باشد و بارگذاری شود، مدل هوش مصنوعی لیپسینک از آن برای تنظیم حرکت دهان استفاده میکند. اگر فقط متن داشته باشید، ابتدا باید گفتار تولید شود.
قابلیتهای مدل هوش مصنوعی sync-3
مدل Sync-3 یکی از پیشرفتهترین مدلهای هوش مصنوعی برای لیپسینک است. تفاوت مهم Sync-3 با مدلهای قبلی، پردازش کل نما بهصورت یکپارچه است. یعنی Sync-3 بهجای بررسی بخشهای کوتاه و مستقل، ارتباط میان فریمهای یک نما را در نظر میگیرد. در این صورت حرکت لب و چهره در طول ویدیو پیوستگی بیشتری دارد.
ورودی تصویر یا ویدیو بههمراه متن یا صدا
Sync-3 از چهار نوع ورودی پشتیبانی میکند:
- ویدیو همراه با فایل صوتی
- ویدیو همراه با متن برای تولید گفتار
- تصویر ثابت همراه با فایل صوتی
- تصویر ثابت همراه با متن برای تولید گفتار
پشتیبانی از تصویر ثابت، باعث میشود مدل حرکت لب را متناسب با گفتار تولید کند. بنابراین برخلاف مدلهای دیگر، وجود ویدیوی اولیه با حرکت طبیعی دهان ضروری نیست.
بررسی کل نما و مدیریت موانع
Sync-3 کل نما را بررسی میکند تا حرکت لب با وضعیت چهره در فریمهای مختلف یکپارچه بماند. این قابلیت در نماهای نزدیک، صورتهای تقریبا خارج از کادر و زاویههای دشوار اهمیت دارد.
مدل همچنین موانعی مانند دست، میکروفون یا شال جلوی صورت را بهطور خودکار تشخیص میدهد. بنابراین، برای هماهنگسازی لب، به تنظیم دستی گزینه تشخیص موانع نیاز ندارد. بااینحال، این قابلیت تضمینکننده ارائه خروجی بدون خطا و بینقص نیست.
تفاوت وضوح چهره و وضوح کل فایل
در مشخصات فنی باید بین وضوح ناحیه چهره و وضوح فایل خروجی ویدیو تفاوت قائل شد. منظور از وضوح چهره جزئیات ناحیه صورت، بهویژه لب، دندان و پوست است. از طرفی، وضوح کل فایل به ابعاد و کیفیت تصویر نهایی در تمام فریمها اشاره دارد. همچنین، Sync-3 برای تولید خروجی چهره با وضوح بومی 4K طراحی شده است
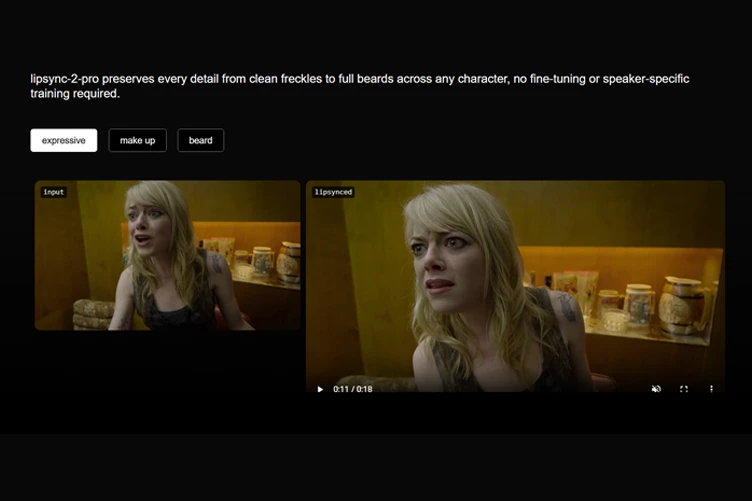
قابلیتهای هوش مصنوعی lipsync-2-pro
LipSync-2-Pro بر لیپسینک با تاکید بر حفظ جزئیات چهره تمرکز دارد. این مدل با استفاده از فناوری Diffusion-based Super Resolution، جزئیات ظریف اطراف دهان را بهتر بازسازی میکند و برای دوبله حرفهای و تغییر دیالوگ ویدیو مناسب است.
حفظ جزئیات دهان، دندان و ریش
LipSync-2-Pro مشکلاتی مانند محوشدن جزئیات یا ایجاد ناهماهنگی در دندان و موهای صورت را در فرایند لیپسینک برطرف کرده است. این مدل در بازسازی موارد زیر تمرکز بیشتری دارد:
- دندانها: طبیعیتر نگهداشتن ظاهر دندانها هنگام تغییر شکل دهان.
- ریش و سبیل: حفظ جزئیات موهای صورت و کاهش محوشدگی اطراف لب.
- جزئیات چهره: بازسازی دقیقتر ناحیه دهان و ویژگیهای ظریف صورت در فریمهای مختلف.
محدودیت در پردازش تصاویر ثابت و ویدیوهای بدون گفتار طبیعی
از آنجا که LipSync-2-Pro برای بازسازی حرکت لب از الگوی تصویری گفتار در ویدیوی ورودی استفاده میکند؛ باید ویدیو در تمام بخش موردنظر حرکت طبیعی دهان را نشان دهد.
در واقع، اگر تصویر ثابت باشد یا فرد در ویدیو صحبت نکند، مدل اطلاعات تصویری کافی برای بازسازی حرکت طبیعی لب نخواهد داشت. حتی فایل صوتی بهتنهایی این محدودیت را رفع نمیکند.
نکته: پشتیبانی از فایل ویدیویی 4K لزوماً به معنای تولید بومی چهره با وضوح 4K نیست.
تفاوت دو مدل sync-3 و lipsync-2-pro و انتخاب نسخه مناسب
اصلیترین تفاوتهای Sync-3 و LipSync-2-Pro بهصورت زیر است:
| معیار مقایسه | Sync-3 | lipsync-2-pro |
| ورودی تصویر | پشتیبانی از تصویر ثابت و ویدیو | نیازمند ویدیو |
| ورودی صوت | فایل صوتی یا متن برای تولید گفتار | فایل صوتی یا متن، بسته به روش تولید |
| حفظ جزئیات چهره | خروجی بومی 4K | حفظ بهتر جزئیات دندان، ریش و اطراف دهان |
| زاویه صورت | پشتیبانی از زاویههای دشوار و نیمرخ | عملکرد محدودتر در زاویههای دشوار |
| انسداد دهان | تشخیص خودکار موانع مانند دست، میکروفون و شال | امکان فعالسازی تشخیص انسداد در تنظیمات |
| پردازش ویدیو | پردازش کل نما بهصورت یکپارچه | پردازش در بخشهای مستقل دوثانیهای |
| هزینه | حدود ۰٫۱۰۷ تا ۰٫۱۳۳ دلار بهازای هر ثانیه | حدود ۰٫۰۶۷ تا ۰٫۰۸۳ دلار بهازای هر ثانیه |
| مناسب برای | تولید حرفهای، نماهای پیچیده و تصاویر ثابت | دوبله حرفهای با تمرکز بر جزئیات صورت |
اگر پیش از هماهنگسازی لب باید برای ویدیو صدا بسازید، راهنمای بهترین ابزار تبدیل متن به صدا میتواند به انتخاب ابزار مناسب برای مرحله تولید گفتار کمک کند.
نمونهی ویدیوی رسمی تولید شده با lipsync-2-pro
ویدیوی زیر یک نمونه از جایگزین شدن دیالوگ و هماهنگی لب و صدا در فیلم Wednesday است که توسط مدل lipsync-2-pro ساخته شده است.
هزینه و قیمت هوش مصنوعی sync-3 و lipsync-2-pro
هزینه استفاده از مدلهای Sync-3 و LipSync-2-Pro به مدل انتخابی، مدت ویدیو و پلن حساب بستگی دارد. نرخ پردازش هماهنگی لب بر اساس هر ثانیه خروجی با نرخ ۲۵ فریم بر ثانیه محاسبه میشود. قیمت تولید گفتار و دوبله نیز جداگانه محاسبه میشود و نباید آنها را با هزینه هماهنگسازی لب یکی دانست. این جدول در تاریخ ۱۹ اکتبر ۲۰۲۶ (۱۴۰۵/۰۷/۲۷) نگارش شده است.
| معیار | Sync-3 | lipsync-2-pro |
| هزینه هماهنگی لب بر حسب ثانیه | ۰٫۱۰۷ تا ۰٫۱۳۳ دلار | ۰٫۰۶۷ تا ۰٫۰۸۳ دلار |
| هزینه هماهنگی لب بر حسب دقیقه | ۶٫۴۲ تا ۷٫۹۸ دلار | ۴٫۰۲ تا ۴٫۹۸ دلار |
نکته: هزینه تولید صدا و اشتراک جداگانه است. طبق جدول صورتحساب Sync Labs، هزینه تبدیل متن به گفتار حدود ۰٫۰۰۳۲ تا ۰٫۰۰۴ دلار بهازای هر ثانیه صوت و هزینه دوبله حدود ۰٫۰۸ تا ۰٫۱۰ دلار بهازای هر ثانیه است. این هزینهها جدا از پردازش هماهنگی لب محاسبه میشوند.
اگر برای دوبله ویدیو به تولید صدای فارسی نیاز دارید، مقاله تبدیل متن فارسی به صدا را نیز مطالعه کنید.
سرویس تبدیل متن به صدا در هوشا
با سرویس تبدیل متن به صدا در پلتفرم هوش مصنوعی هوشا میتوانید متن را به گفتار تبدیل کنید و برای تولید محتوای آموزشی، نریشن ویدیو، فایل صوتی و محتوای شبکههای اجتماعی به کار ببرید.
هوشا همچنین مدلهای جدید تولید صدا sync-3 و lipsync-2-pro را که از زبان فارسی پشتیبانی میکنند، به سایر مدلها اضافه خواهد کرد.
به خاطر داشته باشید که پیش از تبدیل متن به صدا، میتوانید از ChatGPT فارسی برای نوشتن یا بازنویسی متن گویندگی کمک بگیرید.
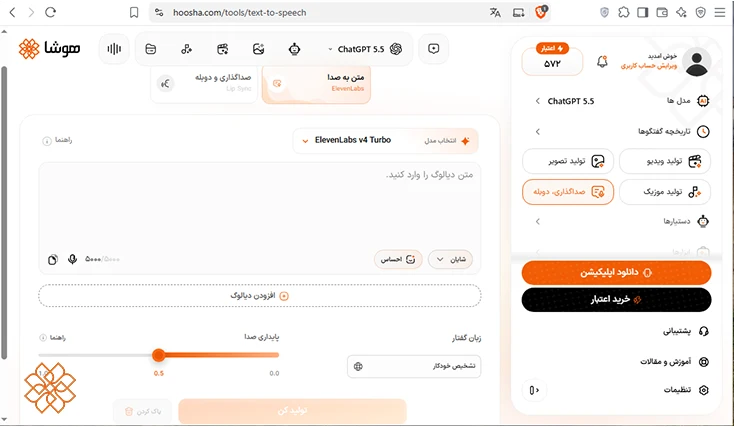
سرویس لبخوانی و دوبله در هوشا
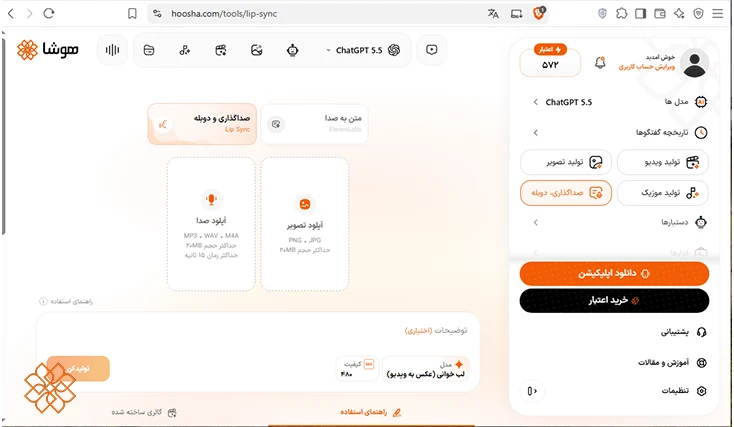
سرویس دوبله و لب خوانی با هوش مصنوعی برای کاربرانی است که میخواهند فرایند آمادهسازی صدای ویدیو را با ابزارهای هوش مصنوعی انجام دهند.
این سرویس دارای دو قابلیت زیر است:
- لبخوانی: تبدیل عکس به ویدیو
- دوبله: تبدیل ویدیو به ویدیو
جمعبندی
مدلهای Sync-3 و LipSync-2-Pro از ابزارهای هوش مصنوعی شرکت Sync Labs برای هماهنگسازی حرکت لب با صدا هستند. اگر به تولید گفتار از متن نیاز دارید، از ابزار تبدیل متن به صدا استفاده کنید؛ اگر میخواهید دیالوگ ویدیو را به زبان دیگری تغییر دهید، به سرویس دوبله نیاز دارید؛ و اگر قصد دارید حرکت لب با صدای جدید هماهنگ شود، مدلهای لیپسینک کاربرد دارند.
هوشا نیز دو سرویس تبدیل متن به صدا و صداگذاری و دوبله را به سایر خدمات خود اضافه کرده است. همچنین، بهزودی مدلهای Sync-3 و LipSync-2-Pro قرار است به این پلتفرم اضافه شوند.
نویسنده: راضیه عبداللهی
۱. تفاوت اصلی دو مدل sync-3 و lipsync-2-pro چیست؟
Sync-3 از ورودی تصویر ثابت و ویدیو پشتیبانی میکند و برای نماهای پیچیده قابلیتهای بیشتری دارد. LipSync-2-Pro روی حفظ جزئیات چهره در ویدیوی گوینده تمرکز دارد. انتخاب مدل به نوع ورودی، نیاز پروژه و بودجه بستگی دارد و هیچکدام نتیجه بینقص را تضمین نمیکنند.
۲. میتوان از متن، ویدیوی لیپ سینک ساخت؟
بله، اما ابتدا باید متن به گفتار تبدیل شود. سپس صدا با تصویر هماهنگ میشود. Sync-3 از تصویر ثابت یا ویدیو پشتیبانی میکند، اما LipSync-2-Pro به ویدیویی نیاز دارد که حرکت طبیعی دهان در آن دیده شود.
۳. عملکرد این مدلها برای زبان فارسی چطور است؟
کیفیت خروجی فارسی به طبیعیبودن صدای ورودی، تلفظ و هماهنگی آن با حرکت لب بستگی دارد.
۴. آیا مدلهای Sync-3 و LipSync-2-Pro اکنون در هوشا فعالاند؟
مدلهای Sync-3 و LipSync-2-Pro قرار است بهزودی اضافه شوند. سرویسهای فعلی تبدیل متن به صدا و صداگذاری و دوبله هوشا فعال هستند.
 تنظیمات چت جی پی تی؛ آموزش تصویری گزینههای کاربردی در وب و موبایل
 Claude Duet معرفی شد؛ کلاد دوئت بدون درخواست کاربر، کار میکند
 هوش مصنوعی انتخاب رشته؛ معرفی، آموزش و مثال برای مقاطع نهم تا دکتری
 هوش مصنوعی پژوهشی آنارا Anara چیست؟ معرفی امکانات و قیمت
