
OpenAI در جریان رویداد DevDay در ۲۹ سپتامبر ۲۰۲۶ یعنی ۷ مهر ۱۴۰۵ از GPT‑6.1 Sol رونمایی کرد؛ نسخهای ارتقایافته از GPT‑6 Sol که برای کارهای حرفهای، کدنویسی، استفاده از رایانه و اجرای فرایندهای چندمرحلهای طراحی شده است.
تمرکز اصلی این مدل، نزدیکشدن به توان GPT‑6 Astra با هزینه کمتر است: بهگفته OpenAI، در برخی ارزیابیها GPT‑6.1 Sol به عملکرد Astra نزدیک میشود، درحالیکه هزینه انجام کار بهمراتب پایینتر است.
GPT‑6.1 Sol چه تفاوتی با GPT‑6 Sol دارد؟

طبق اعلام رسمی GPT‑6.1 Sol مدل کاملاً تازهای در یک خانواده جداگانه نیست؛ OpenAI آن را ارتقایی برای GPT‑6 Sol معرفی میکند. این نسخه در انجام کارهای پیچیدهتر، از جمله نوشتن و اشکالزدایی کد، کار با اسناد و پیشبردن فرایندهای چندمرحلهای کسبوکار بهبود یافته است.
این پیشرفت فقط به امتیاز یک بنچمارک محدود نمیشود. بر اساس دادههای منتشرشده، GPT‑6.1 Sol در چند ارزیابی نسبت به GPT‑6 Sol قبلی بهتر عمل کرده و در بعضی موارد با هزینه کمتر به نتایج GPT‑6 Astra نزدیک شده است. البته Astra همچنان در برخی کارهای پژوهشی دشوار عملکرد بالاتری دارد.
بنچمارکهای GPT‑6.1 Sol
تمامی بنچمارکهای زیر توسط Open AI در صفحه رسمی GPT‑6.1 Sol منتشر شده است.
کدنویسی و مهندسی نرمافزار
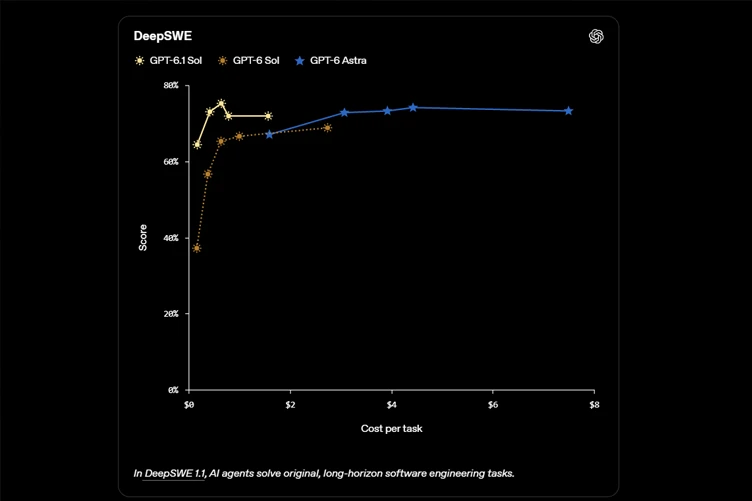
در بنچمارک DeepSWE v1.1 که توانایی عاملهای هوش مصنوعی آنلاین را در حل مسائل طولانی و پیچیده در کدهای واقعی میسنجد، GPT‑6.1 Sol با GPT‑6 Astra به نتیجهای مشابه رسیده است؛ OpenAI میگوید این نتیجه با حدود یکپنجم هزینه Astra به دست آمده است.
در مقایسه با GPT‑6 Sol، نسخه ۶.۱ در این ارزیابی ۶٫۴ واحد درصد امتیاز بیشتری ثبت کرده؛ آن هم با سطح تلاش استدلالی پایینتر. این تفاوت میتواند برای استفادههایی مثل بررسی کد، رفع خطا و انجام تغییرات در پروژههای نرمافزاری اهمیت داشته باشد.
انجام کارهای حرفهای و فرایندهای کسبوکار
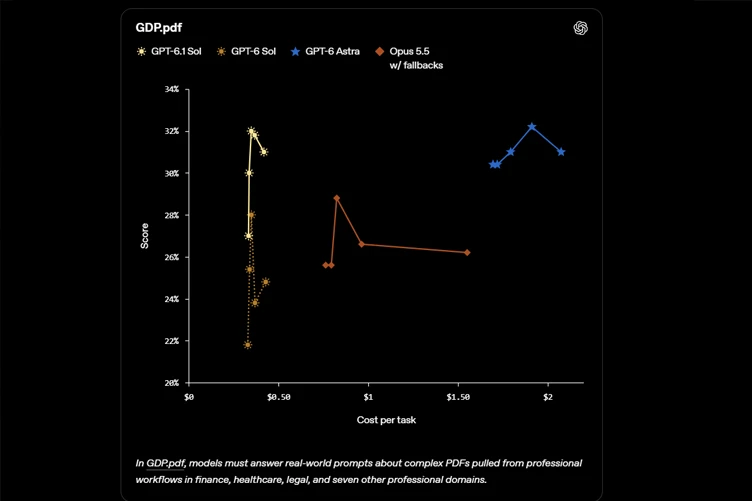
در GDP.pdf، مدل باید با خواندن فایلهای PDF پیچیده، از جمله جدولها، نمودارها و جزئیات ریز، به پرسشهای حرفهای پاسخ دهد. طبق گزارش OpenAI، GPT‑6.1 Sol در این ارزیابی از Claude Opus 5.5 بهتر عمل کرده و هزینه هر کار در تنظیمات آزمایششده کمتر از نصف بوده است. عملکرد آن به GPT‑6 Astra نیز نزدیک شده، با هزینهای حدود یکپنجم آن.
بنچمارک AutomationBench
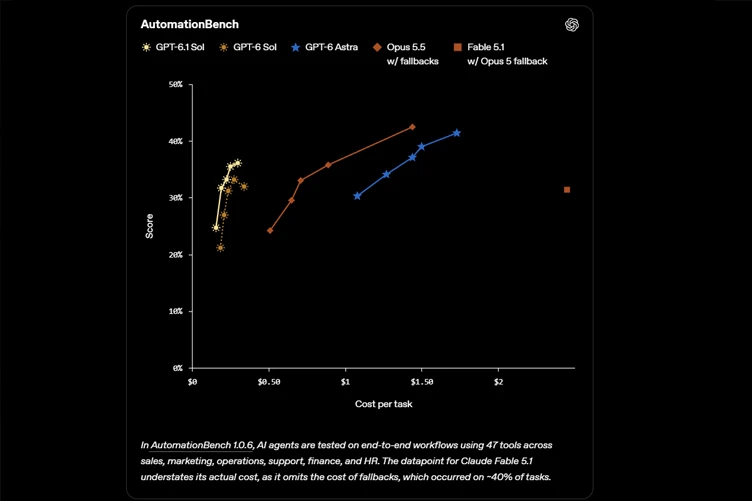
در AutomationBench، که توانایی انجام فرایندهای چندمرحلهای با ابزارهای مختلف را میسنجد، GPT‑6.1 Sol در سطح استدلال متوسط ۲٫۲ واحد درصد بالاتر از Opus 5.5 قرار گرفته و هزینه اجرای کارها حدود یکسوم بوده است. امتیازش در همین تنظیمات نسبت به GPT‑6 Sol نیز ۴٫۸ واحد درصد افزایش داشته است. این آزمون ۴۷ ابزار را در حوزههایی مثل فروش، بازاریابی، پشتیبانی، امور مالی و منابع انسانی پوشش میدهد.
کار با محیط رایانه
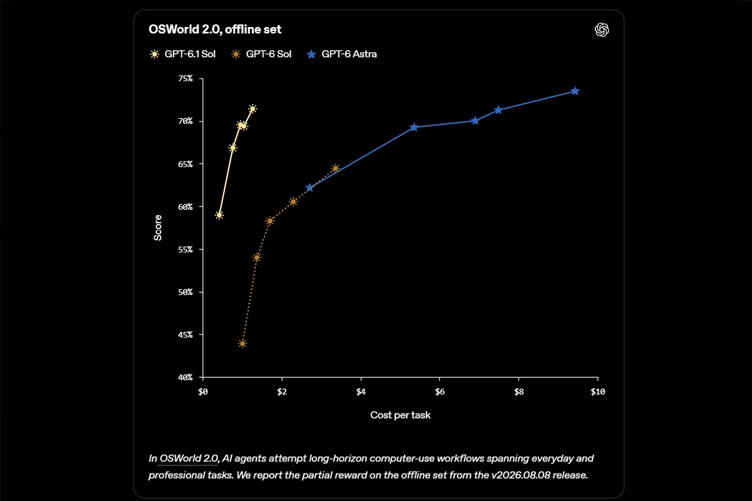
در نسخه آفلاین OSWorld 2.0، که انجام کارهای چندمرحلهای در محیط نرمافزاری را ارزیابی میکند، GPT‑6.1 Sol در سطح بیشینه استدلال ۷ واحد درصد از GPT‑6 Sol بهتر بوده و هزینه کمتری از نصف آن داشته است. امتیازش در همین سطح، ۲٫۱ واحد درصد با GPT‑6 Astra فاصله داشته؛ هزینه اجرای کار نیز بنا بر گزارش OpenAI حدود یکهفتم Astra بوده است.
پژوهش علمی
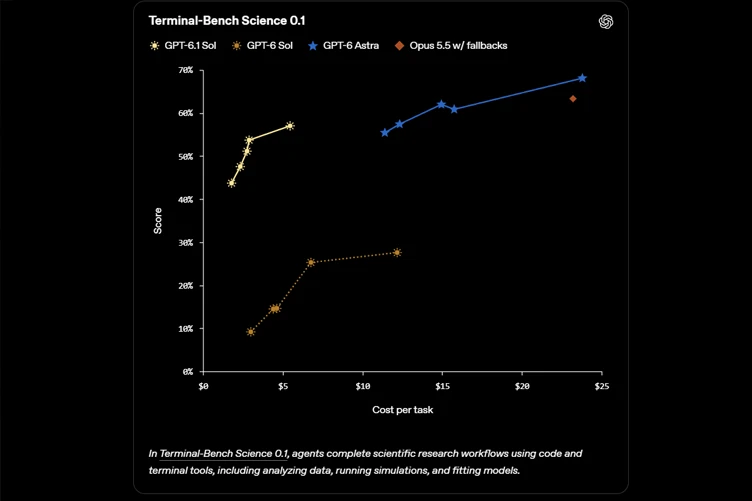
در Terminal‑Bench Science 0.1، عاملها باید با ابزارهای کدنویسی و خط فرمان کارهای پژوهشی مانند تحلیل داده، شبیهسازی و اثبات قضیه را انجام دهند. OpenAI میگوید GPT‑6.1 Sol در سطح بیشینه استدلال بیش از دو برابر GPT‑6 Sol امتیاز گرفته و هزینه اجرای هر کار کمتر از نصف بوده است.
هزینه متوسط هر کار در این سطح برای GPT‑6.1 Sol برابر با ۵٫۴۷ دلار گزارش شده است؛ در مقابل، همین هزینه برای Claude Opus 5.5 حدود ۲۳٫۲۱ دلار و برای GPT‑6 Astra حدود ۲۳٫۸۰ دلار بوده است. با این حال، Astra با امتیاز ۶۸٫۱٪ بالاترین نتیجه را در میان مدلهای بررسیشده ثبت کرده و OpenAI آن را برای دشوارترین مسائل پژوهشی مناسبتر دانسته است.
دقت اطلاعات و پاسخهای واقعی
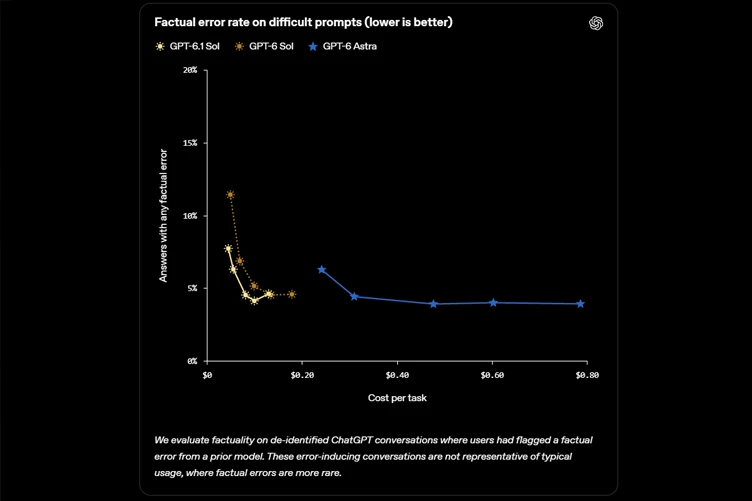
OpenAI برای سنجش خطاهای واقعی، گفتوگوهایی را بررسی کرده که کاربران پیشتر در پاسخهای مدلهای قبلی خطای factual گزارش کرده بودند. در این مجموعه دشوار، سهم پاسخهای دارای دستکم یک خطای اطلاعاتی در GPT‑6 Sol و در سطح استدلال پایین ۱۱٫۴٪ بوده؛ این رقم برای GPT‑6.1 Sol به ۷٫۷٪ رسیده است؛ یعنی حدود ۳۲٪ کاهش.
این آزمایش عمداً شامل پرسشهای خطازا بوده و نماینده همه استفادههای روزمره نیست. بنابراین این درصد را نباید بهعنوان نرخ خطای مدل در تمام مکالمات در نظر گرفت.
مقایسه GPT‑6.1 Sol با مدلهای قبلی و رقیب
| مدل | نکته برجسته در اطلاعات منتشرشده |
|---|---|
| GPT‑6 Sol | مدل پایهای که GPT‑6.1 Sol در کدنویسی، فرایندهای کسبوکار، کار با رایانه و دقت اطلاعات از آن پیشی گرفته است. |
| GPT‑6.1 Sol | نسخه ارتقایافته Sol؛ در برخی بنچمارکها به Astra نزدیک میشود و هزینه اجرای کار را پایینتر نگه میدارد. |
| GPT‑6 Astra | در پژوهش علمی دشوار، بالاترین امتیاز گزارششده در Terminal‑Bench Science 0.1 را دارد؛ در مقایسههای اعلامشده، هزینه کار با آن بالاتر است. |
| Claude Opus 5.5 | در GDP.pdf و AutomationBench، GPT‑6.1 Sol طبق دادههای OpenAI امتیاز بالاتری ثبت کرده است. Opus 5.5 همچنان یکی از مدلهای قدرتمند برای کدنویسی، عاملها و کارهای حرفهای است. |
این مقایسهها باید با توجه به روش اجرای آزمونها خوانده شوند. OpenAI میگوید آزمونهای مدل خودش در محیط پژوهشی یا از طریق API اجرا شدهاند؛ خروجی این محیطها ممکن است بهدلیل تفاوت در پیامهای سیستمی، ابزارها یا سطح تلاش با نسخههای مصرفی فرق داشته باشد. همچنین دادههای برخی مدلهای رقیب از گزارشهای عمومی آنها گرفته شده است.
در صفحه رسمی آنتروپیک، Claude Opus 5.5 بهعنوان مدل قدرتمند این شرکت برای کدنویسی عاملمحور، کارهای چندابزاری و دانش حرفهای معرفی شده است. Anthropic میگوید این مدل نسبت به Opus 5 هزینه کمتری دارد و نرخ API آن ۴ دلار برای هر یک میلیون توکن ورودی و ۲۰ دلار برای هر یک میلیون توکن خروجی است. بنابراین مقایسه هزینه واقعی دو مدل به نوع کار، تعداد توکنها، میزان استفاده از حافظه کش و شیوه اجرای عامل نیز بستگی دارد.
Claude Sonnet 5.5 معرفی شد؛ قیمت، بنچمارکها
قیمت GPT‑6.1 Sol چقدر است؟
قیمت رسمی API برای هر یک میلیون توکن به این شکل اعلام شده است:
| نوع توکن | قیمت |
|---|---|
| توکن ورودی | ۲ دلار |
| توکن ورودی ذخیرهشده در کش | ۰٫۱۰ دلار |
| توکن خروجی | ۱۰ دلار |
قیمت توکن ورودی ذخیرهشده در کش ۹۵٪ کمتر از ورودی عادی است. این ویژگی میتواند در درخواستهایی که زمینه یا دستورهای مشابه را در چند نوبت تکرار میکنند، هزینه را کاهش دهد. OpenAI همچنین از عرضه حالت Ultrafast برای Codex خبر داده که بنا بر اعلام شرکت، میتواند سرعت تولید توکن را تا ۸ برابر افزایش دهد؛ این حالت قرار است جداگانه ارائه شود.
GPT‑6.1 Sol در کجا در دسترس است؟
طبق اعلام OpenAI، GPT‑6.1 Sol از زمان معرفی برای کاربران Plus، Pro، Business، Enterprise و Edu در محیطهای ChatGPT Work و Codex در دسترس قرار گرفته است. این مدل فعلاً در بخش معمولی چت جی پی تی ارائه نشده است. توسعهدهندگان نیز میتوانند از طریق API و با شناسه gpt-6.1-sol به آن دسترسی پیدا کنند.
جمعبندی؛ GPT‑6.1 Sol برای چه کسانی مناسب است؟
GPT‑6.1 Sol برای کسانی جذاب است که مدل را در کارهای حرفهای و چندمرحلهای بهکار میگیرند و در کنار کیفیت، به هزینه اجرا هم توجه دارند؛ بهویژه برای کدنویسی، کار با اسناد پیچیده، خودکارسازی فرایندهای کسبوکار و کار با محیط رایانه.
دادههای OpenAI نشان میدهد این مدل نسبت به GPT‑6 Sol پیشرفت کرده و در بعضی آزمونها با هزینه کمتر به نتایج GPT‑6 Astra نزدیک شده است. با این حال، Astra در برخی کارهای علمی دشوار همچنان امتیاز بالاتری دارد. بنچمارکها برای مقایسه مفیدند، اما بهتنهایی کیفیت پاسخ در همه کاربریها را تضمین نمیکنند.
دسترسی به مدلهای هوش مصنوعی در هوشا
در هوشا میتوانید به مدلهای مختلف هوش مصنوعی دسترسی داشته باشید و برای نیازهای متفاوت از میان آنها انتخاب کنید. در حال حاضر Claude Opus 5، Claude Opus 5.5 و GPT‑5.6 در هوشا در دسترساند. اگر میخواهید توانایی مدلهای مختلف را برای گفتوگو، تحلیل یا کارهای حرفهای امتحان کنید، میتوانید از مدلهای هوش مصنوعی هوشا استفاده کنید.
 هوش مصنوعی دریمینا (Dreamina) | بررسی قابلیتها، محدودیتها و قیمت
 ایجنت هوش مصنوعی؛ از تعریف و کاربرد تا امنیت و هزینه AI Agent
 هوش مصنوعی پیکس ورس چیست؟ آموزش کامل PixVerse، قابلیتها و قیمت
 چت جی پی تی گو؛ امکانات، قیمت و مقایسه ChatGPT Go با پلن Plus
 معرفی GPT‑6.1 Sol؛ نزدیک به توان GPT‑6 Astra با هزینه کمتر
