
بنچمارک LifeVal یک چارچوب ارزیابی جدید شرکت OpenAI است که میسنجد مدلهای هوش مصنوعی تا چه اندازه میتوانند در انجام وظایف و تصمیمهای واقعی زندگی روزمره به انسانها کمک کنند. این بنچمارک بهجای تمرکز صرف بر آزمونهای نظری، توانایی مدلها را در انجام کارهای عملی از چند جنبه زیر بررسی میکند:
- سنجش کاربرد واقعی به جای تستهای تئوری: تمرکز روی حل مشکلات واقعی زندگی به جای حل فرمولهای سخت ریاضی یا آزمونهای کدنویسی دانشگاهی.
- بر پایه آمار واقعی زندگی مردم: طراحی شده با کمک اطلاعات دو پژوهش بزرگ و نظرسنجی از ۳٬۹۹۵ کاربر واقعی.
- بررسی ۱۶۹ کار عملیاتی و واقعی: سنجش توانایی هوش مصنوعی در کار با مرورگر اینترنت، کامپیوتر و ابزارهای مختلف برای به سرانجام رساندن کارها.
- پوشش ۷ بخش اصلی زندگی روزمره: از مدیریت پول و هزینهها گرفته تا سلامت، کارهای خانه، خرید، آموزش و کارهای اداری.
- بررسی قدرت مدلها در سطوح مختلف تفکر: مقایسه عملکرد مدلهای خانواده GPT از کمترین تا بیشترین میزان توان فکری.
بنچمارک LifeVal چیست و چرا ساخته شد؟

بیشتر آزمونهایی که تا امروز برای هوش مصنوعی طراحی شدهاند، روی حافظه، حل مسائل سخت ریاضی یا نوشتن کدهای پیچیده تمرکز داشتهاند. اما نمره عالی گرفتن در این آزمونها تضمین نمیکند که یک دستیار هوشمند بتواند در دنیای واقعی هم به درد ما بخورد.
به همین دلیل شرکت OpenAI بنچمارک LifeVal را معرفی کرده است تا ببیند مدلهای هوش مصنوعی چقدر در کارهای عادی و روزمره به کمک انسانها میآیند.
در زندگی روزمره، بیشتر ما دنبال راهی هستیم تا کارهای وقتگیر مثل ثبتنام مدرسه، هماهنگ کردن نوبت دکتر یا حسابوکتاب هزینهها را سریعتر انجام دهیم. بنچمارک LifeVal دقیقاً میخواهد ببیند آیا هوش مصنوعی میتواند به جای حرف زدن و نصیحت کردن، واقعاً باری از دوش ما بردارد یا خیر.
بنچمارک LifeVal چه تفاوتی با آزمونهای قدیمی دارد؟
در آزمونهای قبلی، معیار موفقیت هوش مصنوعی این بود که متن جواب چقدر به یک پاسخ از پیش تعیینشده شبیه است. اما در زندگی واقعی، کارها به این سادگی نیستند؛ اطلاعات ممکن است ناقص باشند و کارهای اداری هم پیچیدگیهای خود را دارند.
بنچمارک LifeVal نشان میدهد که اگر هوش مصنوعی فقط یک سری توضیحات قشنگ تحویل دهد ولی همه دوندگیها را روی دوش کاربر بگذارد، کمک خاصی نکرده است. یک دستیار واقعی باید تفاوت بین «توضیح دادن کار» و «تمام کردن کار» را بداند و بدون اتلاف وقت کاربر، کار را پیش ببرد.
نحوه طراحی بنچمارک LifeVal و شیوه جمعآوری اطلاعات
وظایف بنچمارک LifeVal ساختگی و فرضی نیستند، بلکه محققان بررسی کردهاند که مردم در طول شبانهروز واقعا وقت خود را چطور میگذرانند.
برای این کار از دو تحقیق آماری بسیار بزرگ کمک گرفته شد:
- آمار نحوه گذران وقت در آمریکا (ATUS): این پژوهش رسمی نشان میدهد مردم در طول روز چقدر وقت را صرف کارهای خانه، مراقبت از فرزندان، خرید و پیگیری کارهای اداری میکنند.
- مطالعه چندملیتی زمان (MTUS): این پژوهش، اطلاعات بیش از یک میلیون برنامه روزانه را در ۳۰ کشور مختلف در طول ۵۵ سال جمع کرده و نشان میدهد سبک زندگی و کارهای مردم چطور تغییر میکند.
در کنار این آمارها، یک نظرسنجی از ۳٬۹۹۵ نفر انجام شد تا مشخص شود مردم بیشتر دوست دارند کدام کارهای خستهکننده را به یک دستیار هوشمند بسپارند. ترکیب این اطلاعات به ۱۶۹ کار عملیاتی تبدیل شد که در آنها مدل باید بتواند در وب بچرخد، با کامپیوتر کار کند و ابزارهای مختلف را برای انجام هدف کاربر به کار بگیرد.
Open AI چیست؟ آشنایی با شرکت Open AI
۷ حوزه ارزیابی LifeVal؛ از مراقبت و سلامت تا خدمات دولتی
کارهایی که در بنچمارک LifeVal سنجیده میشوند به ۷ بخش اصلی تقسیم شدهاند:
- مراقبت از اعضای خانواده (Caregiving): کمک به نگهداری فرزندان، سالمندان و تنظیم برنامههای مراقبتی در خانه.
- سلامت و درمان (Health): بررسی هزینههای درمان، هماهنگی نوبتهای پزشکی و تنظیم برنامه غذایی و ورزشی.
- آموزش و یادگیری (Education): پیدا کردن مدرسه یا مهدکودک مناسب، ثبتنام در دورهها و مدیریت تکالیف بچهها.
- کارهای اداری و روزمره خانه (Household administration): پیگیری فاکتورها و اسناد خانه، آماده شدن برای شرایط بد آبوهوایی و تعمیرات.
- مدیریت پول و بودجه شخصی (Personal finances): بودجهبندی هزینههای ماهانه، برنامهریزی برای پسانداز و نظم دادن به خرجها.
- خرید مایحتاج (Shopping): پیدا کردن بهترین کالاها با قیمت مناسب بر اساس بودجه و نیاز خانواده.
- استفاده از خدمات دولتی (Accessing government services): پر کردن فرمهای مالیاتی، کارهای بیمه و دریافت مجوزهای اداری.
امتیاز مدلهای GPT در بنچمارک LifeVal
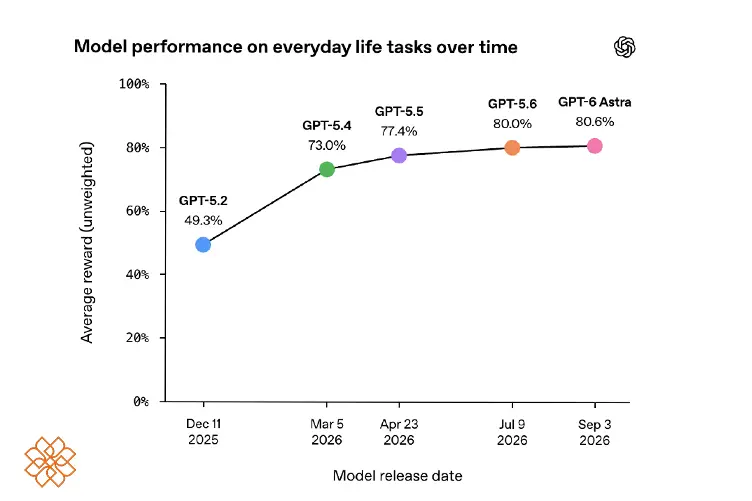
آزمایشهای LifeVal نشان میدهد که وقتی مدلها باهوشتر میشوند، چقدر در کارهای روزمره بهتر عمل میکنند.
در این ارزیابی، نمره هر مدل بر اساس درصد موفقیتی است که در ۱۶۹ کار مختلف به دست آورده است.
جدول عملکرد مدلهای GPT در سطوح مختلف تفکر
جدول زیر نمرات مدلهای مختلف ChatGPT را در حالتهای مختلف فکر کردن (Reasoning Effort) نشان میدهد:
| مدل هوش مصنوعی | سطح تفکر پایین (Low) | سطح تفکر متوسط (Medium) | سطح تفکر بالا (High) | سطح تفکر خیلی بالا (Xhigh) | حداکثر سطح تفکر (Max) |
| GPT-5.2 | ۲۷.۷٪ | ۳۷.۲٪ | ۴۵.۲٪ | ۴۹.۳٪ | ارزیابی نشده |
| GPT-5.4 | ۶۲.۸٪ | ۷۰.۱٪ | ۷۲.۰٪ | ۷۳.۰٪ | ارزیابی نشده |
| GPT-5.5 | ۵۷.۱٪ | ۷۱.۳٪ | ۷۵.۶٪ | ۷۷.۴٪ | ارزیابی نشده |
| GPT-5.6 | ۶۳.۹٪ | ۷۵.۰٪ | ۷۸.۸٪ | ۸۰.۰٪ | ۸۲.۶٪ |
| GPT-6 Astra | ۶۶.۶٪ | ۷۷.۶٪ | ۸۰.۷٪ | ۸۰.۶٪ | ۸۲.۵٪ |
اختلاف نمرات از GPT-5.2 تا مدلهای جدیدتر مثل GPT-5.6 و نسل ۶ به وضوح نشان میدهد که توانایی مدلها در حل چالشهای روزمره رشد چشمگیری داشته است. مدلهای قدیمیتر وقتی به یک مرحله مبهم میرسیدند به سادگی متوقف میشدند یا اشتباه میکردند، اما مدلهای تازه بیشتر کارها را با موفقیت تمام میکنند.
رابطه سطح تفکر مدل هوش مصنوعی با عملکرد و هزینه
یکی از نکات جالب در نتایج بنچمارک LifeVal این است که تنظیم مدل روی بیشترین حد تفکر، همیشه بهترین نتیجه را به همراه ندارد. برای مثال، مدل GPT-6 Astra در حالت تفکر بالا به نمره ۸۰.۷ درصد رسیده، اما بردن آن به حالت تفکر خیلی بالا نمره را به ۸۰.۶ درصد رسانده که عملاً تغییری در کیفیت کار ایجاد نکرده است.
حتی در بالاترین حد تفکر، مدل GPT-5.6 با نمره ۸۲.۶ درصد توانسته کمی بهتر از GPT-6 Astra با نمره ۸۲.۵ درصد عمل کند.
این نتیجه به ما یادآوری میکند که برای کارهای روزمره زندگی، حالتهای متوسط یا بالای تفکر کاملاً کار را راه میاندازند و نیازی نیست با انتخاب حداکثر توان، هزینههای بیهوده پرداخت شود.
سناریوهای واقعی در بنچمارک LifeVal و نتایج گزارششده
نگاهی به ۵ نمونه از کارهای آزمایششده در این بنچمارک نشان میدهد هوش مصنوعی چطور وارد زندگی واقعی میشود. معیار سنجش این بوده که هوش مصنوعی چقدر توانسته کار را تمام کند و بارِ روی دوش کاربر را سبک کند.
| عنوان سناریو و شرح وظیفه | امتیاز ثبتشده | خروجی اجرایی مدل |
| پیدا کردن خانه در منطقه Luzerne: یافتن خانهای متناسب با بودجه، دارای فضای مستقل و مسیر رفتوآمد کوتاه پس از رساندن فرزند به مدرسه. | ۱۰۰٪ | تطبیق شروط و بودجه، محاسبه دقیق مالیات و اضافه کردن سند ملک به سبد بررسی نهایی کاربر در وبسایت املاک. |
| هماهنگی نیروهای داوطلب قبل از سیل: آمادهسازی سریع برای کمک به ۴ خانواده همسایه که قبل از شروع طوفان نیاز به مهار آب دارند. | ۹۸.۰٪ | نوشتن برنامه کاری ساده و مشخص کردن وظیفه هر داوطلب برای سرکشی به خانهها و ایمنسازی آنها. |
| تماشای مسابقه با مادربزرگ از راه دور: آماده کردن یک راه ساده برای تماشای دورهمی بازی ورزشی با مادربزرگ سالمند. | ۹۶.۳٪ | تنظیم آسانترین راه پخش آنلاین به همراه یک راهکار جایگزین در صورتی که تصویر قطع شد. |
| ثبتنام مهدکودک بعد از اثاثکشی: بررسی مهدکودکهای نزدیک خانه و انتخاب بهترین گزینهها متناسب با ساعت کار والدین. | ۹۳.۱٪ | معرفی ۳ گزینه برتر، مرتب کردن شرایط ثبتنام و سپردن تصمیم نهایی به والدین. |
| برنامه غذایی برای بیماری دیابت: کمک به پدر یا مادری که تازه متوجه شده دیابت دارد برای تغییر برنامه غذا و زندگی. | ۹۰.۴٪ | تنظیم برنامه هفته اول شامل غذاها، یادآور مصرف دارو و چکلیست سوالاتی که باید از دکتر بپرسند. |
عبور هوش مصنوعی از حرف زدن ساده به انجام عمل
همانطور که در گزارش وبسایت رسمی این شرکت (OpenAI) آمده است، هوش مصنوعی دیگر فقط یک برنامه ساده برای گفتگو نیست، بلکه دارد به دستیاری تبدیل میشود که دستبهکار میشود و کار را تمام میکند.
مثلاً برای کمک به بیماری که دیابت دارد، دستیار هوشمند فقط یک فهرست از غذاهای ممنوعه تحویل نمیدهد؛ بلکه زمانبندی تزریق، عادتهای غذایی و حتی سوالاتی که باید از پزشک پرسیده شود را هم آماده میکند.
این تفاوت باعث میشود هوش مصنوعی واقعاً کارایی داشته باشد. به این ترتیب، کاربر به جای ساعتها جستجوی گیجکننده در اینترنت، مستقیماً یک برنامه آماده و مرتب دریافت میکند.
علاوه بر مدلهای OpenAI، غولهای فناوری دیگر هم ابزارهای هوشمندی را برای کمک به کارهای روزمره آماده کردهاند.
معرفی هوش مصنوعی Gemini و هر آنچه که باید بدانید
محدودیتهای LifeVal؛ چرا نتایج آن را باید با احتیاط تفسیر کرد؟
با اینکه بنچمارک LifeVal قدم بزرگی برای ارزیابی کاربرد واقعی هوش مصنوعی است، کارشناسان به چند نکته و محدودیت مهم در آن اشاره کردهاند:
- اولین موضوع این است که اطلاعات و کدهای این بنچمارک به صورت عمومی منتشر نشده است. یعنی متن سناریوها و روش نمرهدهی داور به طور شفاف مشخص نیست و محققان مستقل در دانشگاهها نمیتوانند این آزمایشها را دوباره تکرار کنند تا درستی نتایج را بسنجند.
- نکته دوم این است که در گزارش رسمی فقط مدلهای خود شرکت OpenAI سنجیده شدهاند و خبری از مدلهای رقیب نیست. به همین دلیل نمیتوان فهمید هوش مصنوعی شرکتهای دیگر در این کارهای روزمره چقدر موفق عمل میکنند.
همچنین نمونههایی که در گزارش منتشر شده همگی نمرههای بالای ۹۰ درصد دارند، در حالی که میانگین واقعی کل کارها حدود ۸۰.۶ درصد بوده است؛ یعنی فقط نمونههای گلچینشده و موفق به نمایش درآمدهاند.
در نهایت هم به ارزش مالی کارها توجهی نشده و همه کارها، چه ساده و چه بااهمیت، با وزن یکسانی سنجیده شدهاند.
جمعبندی
معرفی بنچمارک LifeVal نشان میدهد که دوران رقابت بر سر نمرههای تئوری و حفظ کردن فرمولها رو به پایان است. امروزه ارزش واقعی هوش مصنوعی زمانی مشخص میشود که بتواند در شلوغیهای یک روز معمولی به کمک ما بیاید، کارهای وقتگیر اداری و خانگی را سروسامان دهد و باری از دوش ما بردارد.
آزمایش ۱۶۹ کار مختلف در این بنچمارک ثابت میکند که مدلهای جدید هوش مصنوعی در حال تبدیل شدن به ابزارهایی کنشگر و عملگرا هستند.
البته تا زمانی که این آزمونها به شکل عمومی در دسترس پژوهشگران مستقل قرار نگیرند و مدلهای سایر شرکتها در آن سنجیده نشوند، نمیتوان ادعاهای مطرحشده را نتیجه قطعی دانست. با این حال، بنچمارک LifeVal مسیر تازهای را پیش روی دنیای فناوری گذاشته است: ساختن دستیارهایی که هدف اصلیشان آسانتر کردن زندگی روزمره انسانهاست.
در نهایت نیز اگر میخواهید برای کارهای شخصی، اداری یا تولید محتوای خود از بهترین مدلهای دنیا استفاده کنید، مراجعه به یک سایت هوش مصنوعی جامع و معتبر میتواند تمام نیازهای شما را یکجا برطرف کند.
نویسنده: معین معرک نژاد
۱. بنچمارک LifeVal دقیقاً چه چیزی را اندازه میگیرد؟
این بنچمارک بررسی میکند که هوش مصنوعی تا چه حد میتواند ۱۶۹ کار واقعی در زندگی روزمره مثل هماهنگیهای پزشکی، بودجهبندی ماهانه، کارهای اداری و ثبتنامهای آموزشی را به سرانجام برساند.
۲. چرا آزمونهای قدیمی برای سنجش کارهای روزمره کافی نبودند؟
آزمونهای قدیمی فقط پاسخهای تئوری و کدهای برنامهنویسی را ارزیابی میکردند و نشان نمیدادند که آیا مدل میتواند با کامپیوتر و اینترنت کار کند و یک مشکل واقعی را حل کند یا نه.
۳. اطلاعات این بنچمارک از کجا به دست آمده است؟
این آزمون بر اساس دو تحقیق بزرگ درباره نحوه گذران وقت انسانها و یک نظرسنجی از ۳٬۹۹۵ نفر درباره کارهای خستهکننده روزمره طراحی شده است.
۴. آیا کدهای بنچمارک LifeVal به صورت عمومی منتشر شدهاند؟
خیر، سناریوها و معیارهای امتیازدهی داور هنوز به طور عمومی منتشر نشده و فعلاً فقط نتایج مدلهای خود شرکت سازنده اعلام شده است.
۵. کدام حالت تفکر (Reasoning Effort) برای کارهای روزمره بهتر است؟
نتایج نشان میدهند حالتهای متوسط یا بالا بهترین بازدهی را دارند، زیرا انتخاب بیشترین حد تفکر تفاوت زیادی در خروجی کار ایجاد نمیکند و فقط هزینه پردازش را بالا میبرد.
 برنامه Grid Protectors اوپن ای آی و مدیریت مصرف برق مراکز داده
 بنچمارک LifeVal شرکت OpenAI؛ سنجش عملکرد هوش مصنوعی در کارهای روزمره
 رونمایی OpenAI از Pando؛ توسعه نرمافزار با کمک Codex تا ۵ برابر سریعتر
 افزونه کودو (Qodo) برای Codex رونمایی شد؛ بازبینی کد با شناخت قواعد تیم
